[카테고리:] 미분류

  • [개발생각] 조건이 많은 기능들을 앱에 노출해야하는경우

    조건이 많은 기능들을 앱에 노출해야하는 경우, 상당히 API가 많아질수있다.

    1) 홈화면에 카드형식의 데이터들을 노출해야할때, 각각의 카드는 노출해야하는 조건들이 다르다.

    – 각카드별로 노출여부 조건을 조회하는 API를 호출하고 해당 API의 응답을 클라이언트가 판단하여, 카드를 노출한다.

    2) 미션탭에서, 각각의 미션의 조건이 다르다.

    – 각각의 미션은 미션수행의 조건이나 노출여부가 사용자마다 다르고 이또한 조건을 조회하는 API를 조회하여 노출여부를 판단한다.

    일반적인 방법으로 구현을 하게되면,

    클라이언트에서 각각의 조건에 맞는 API들을 다수 호출하게 되고,

    그 API들또한 미묘하게 동일한 데이터를 포함하거나, 중복되는 호출의 API일 가능성이 높아진다.

    이런 API들을 미션이나 홈카드 노출전용으로 묶어서 제공하게 되면,

    이또한 중복이나, 각각의 전용 API들이 나오게 되어,

    불필요하거나 중복된 API들이 만들어지게 되고, 관리의 문제또한 발생하게 된다.

    이런경우는 이렇게 룰을 가져갔다.

    홈카드, 미션수행 리스트를 내려주는 API를 만들고 해당 API안에서 각각의 카드, 미션에 대한 조건을 모두 판단하여,

    실제 클라이언트가 노출해야하는 리스트를 모두 서버에서 한번에 판단하여 내려준다.

    그리고 클라이언트는 해당 응답 리스트에있는 항목에 대해서만,

    상세조회를 하여, 카드, 미션의 내용을 채우게 룰을 가져갔다.

    이렇게 되면,

    필요한 조건들은 모두 서버에서 한번에 조건 필터링하여 목록으로 내려주기때문에,

    클라이언트가 불필요하게 여러 API를 호출한 필요가 없고,

    향후 조건이 변경되는 경우도,

    서버에서 해당 조건에 맞게 리스트를 내려주게 수정만 하면 일괄적으로 적용이 된다.

    그리고 조건에서 무거운 쿼리 조회나 수행을 하는 데이터또한 내부적으로 재사용가능하기에, 성능면에서도 향상되는 이점이 있다.

    API로 앱의 기능을 호출하여 구현할때는 이런 룰들이 잘정리되어야, 불필요하고, 중복된 API들이 많이 생겨나지 않게되고,

    성능또한 높일수있다.

    (무거운 기능인 경우는 캐시또한 일괄로 적용할수있어, 이점이 많다)

    별것이 아니라고 생각을 하겠지만,

    이런 작은 룰들이 결국 퍼포먼스와 유지보수 모두를 잡을수있는 초석이 된다는것 명심하자…

  • [아이디어] 삼성,엘지 가전 제어, 어떻게 할까?

    삼성,엘지 가전에는 AutoDr이라는 개념이 있다.

    전기소비를 줄이라는 캠페인(DR)이 한국전력거래소(KPX)에서 발령이 되면,

    해당 발령을 공공데이터포털의 OpenApi를 통해 이벤트를 받을수도있고, 관련한 제휴업체들은 직접 이벤트를 받을수도있다.

    이 이벤트를 받았을때,

    가전제품 특히 전기를 많이 먹는 에어콘, 온풍기등을 Off하거나, 온도를 조절하는등으로 전기사용량을 제어를 하면,

    전기소비를 줄일수있다.

    요즘은 삼성,엘지 가전에서는 삼성스마트띵스, 엘지띵큐등으로 가전을 제어할수있는 API를 사용자에게 오픈하고 있다.

    DR이벤트를 받을수있고, API를 사용하여, 가전의 제어를 할수있다면, AUTODR (자동으로 전력소비를 줄이는 행위)를 할수있다.

    여기서 중요한건, 해당 API를 서버에서 날리는 방법보다는, 앱에서 호출을 하면 서버가 필요없다는 큰 장점이 있다.

    (서버 비용, API 호출량 회피, 아이피 블록등)

    앱에서 호출을 한다면 넘어야하는 이슈가 하나있다.

    일반적으로는 앱이 활성화/실행된상태라면, API를 호출할수가 있겠지만,

    앱을 종료한 상태, 스마트폰이 잠긴상태로 있는경우는 DR이벤트를 받을수도, 제어 API를 호출할수도없다.

    앱이 활성화가 되지않았기 때문이다.

    이런 이슈에 대해서 해결할수있는 방법을 생각했다. 

    일명 ‘하이브리드 작전’ 이랄까? 

    실버 불릿은 없다 라는 명언이 있지…

    100% 한방에 해결할수있는 방법을 찾기는 쉽지않다.

    방법마다의 문제가 있기에, 해당 방법들을 잘 조합하여, 그 문제를 보완해나가는 방법을 사용하여야 한다.

    우선 생각한 방법은 아래와 같다.

    (우선 Android앱 위주로 설명한다. 비슷한 기능이 IOS앱에도 있다)

    1) WorkManager라는 기능을 활용한다.

      – 해당 기능은 안드로이드에 일정 주기로 동작하는 스케줄러를 등록할수있다.

        (해당 스케줄러를 등록하고 해당 스케줄러에서 API호출을 하는 방식으로 기기를 제어한다) 

      – 단, 정확하게 해당 스케줄러가 동작한다는 보장은 100%없다.

    2) Data Notification기능을 활용한다.

      – 앱푸시로 아래와 같이 data 필드를 전달하면,

    {
      "to": "<FCM_TOKEN>",
      "data": {
        "type": "DR_START",
        "eventId": "12345",
        "startTime": "2026-07-09T20:00:00"
      }
    }
    class MyFirebaseMessagingService : FirebaseMessagingService() {
    
        override fun onMessageReceived(message: RemoteMessage) {
            val data = message.data
    
            val type = data["type"]
            val eventId = data["eventId"]
            
            if (type == "DR_START") {
                // DR 이벤트 처리
                // 삼성,엘지 가전 제어 API 호출!!!
            }
        }
    }

    위와같이 푸시 이벤트가 스마트폰으로 수신될때,  onMessageReceived함수로 이벤트를 받을수있다.

    따라서 해당 함수안에서 삼섬,엘지 가전 제어 API를 호출하면 된다.

      – 단, 이 방법 또한, 정확하게 해당 스케줄러가 동작한다는 보장은 100%없다.

    3) 1,2번이 모두 실패시, 마음편하게 서버에서 가전제어 API를 호출한다.

    위 3가지 방법을 조합하면, 100%로 가전을 제어할수있는 기능을 구현할수있다.

    흐름은 아래와 같다.

    WorkManager –> 실패시 —> Data Notification —> 실패시 —> 서버에서 API호출.

    나름 좋은 아이디어 방법인듯하다.

    가전 제어기능을 제공하는 사업체에서는 서버에서의 API호출을 줄일수있고, 사용자의 앱에서 제어가 대부분 이루어지게 할수있기에,

    보안적 측면과 사업적 측면에서도 큰 장점이 될수있는 방법으로 보인다.

    현재 위 방법으로 샘플앱을 하나 만들어서, 테스트중인데, 예상한대로 잘 동작한다…(흐믓하구나…ㅋ)

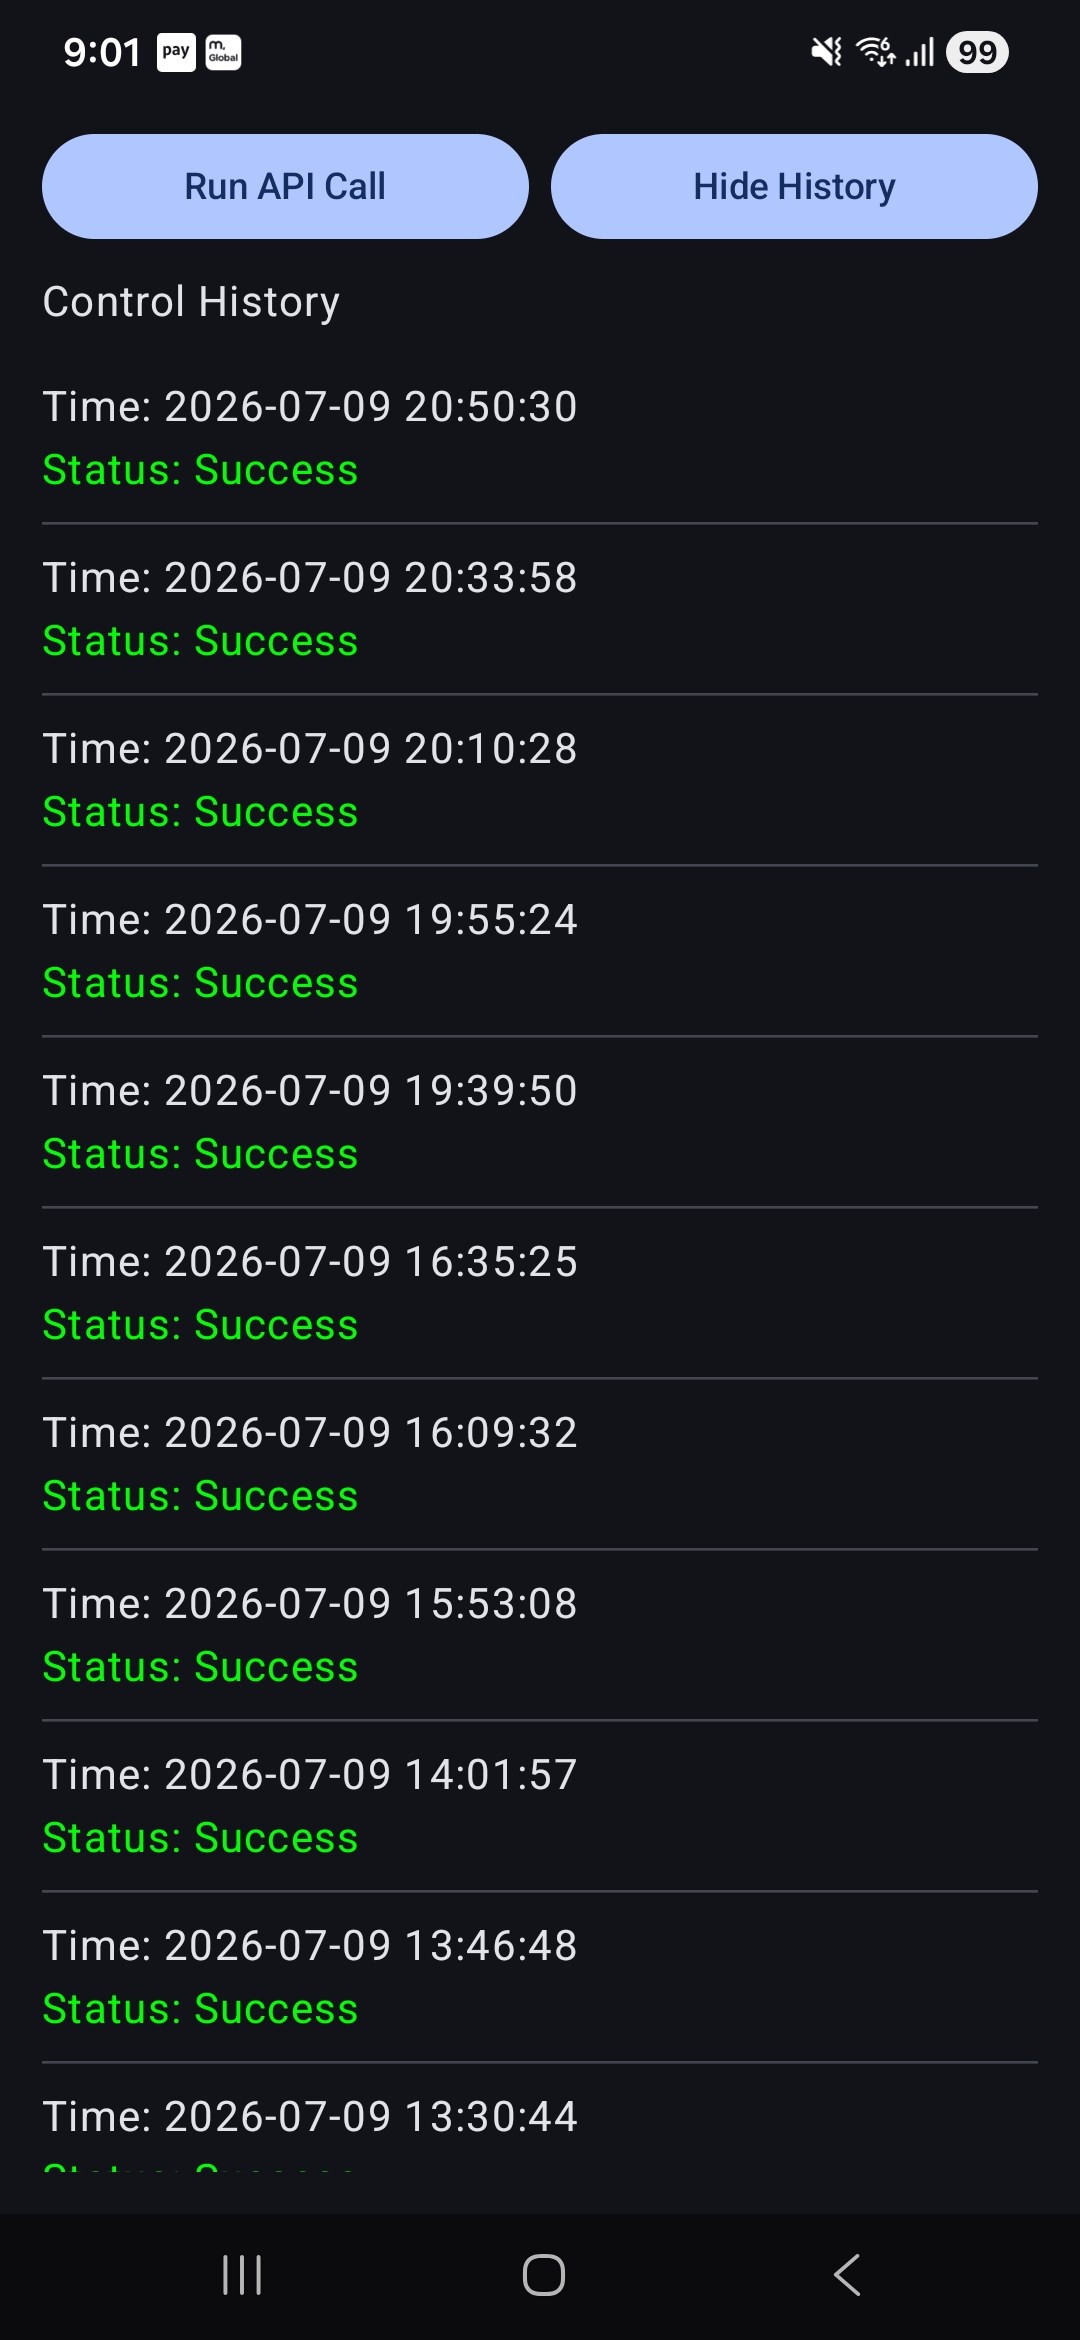
    아래 스샷은 만들어본 샘플앱으로써,

    앱을 껴두고,  백그라운드에서 자동으로 가전제어 API를 호출하고 해당 결과를 로그로 쌓아서, 볼수있게 앱을 간단히 만들었다.

    15분 간격으로 API를 호출하게 만들었는데, 나름잘동작한다.

    물론, WorkManager가 정확히 개발자가 설정한 시간(15분등)으로 동작을 보장해주지는 않는다.

    따라서, 2번, 3번 방법으로 해당 단점을 보완 하여야하는것이다.

  • [개발생각] 주소기반 데이터 조회를 위한 방법은?

    진행중인 프로젝트에서 주소기반으로 동일한 지역, 비슷한 지역내의 사용자들의 에너지 데이터들의 통계를 내야하는 경우가 발생했다.

    기본적으로는 주소데이터를 컬럼으로 추가하고, 같은 지역으로 GroupBy를 하여 통계를 내는 방식을 사용하지만,

    이렇게 주소데이터 컬럼을 사용하게되면,

    군, 시, 도로 확장해나갈때, 쉽게 그룹핑을 하기가 애매해진다.

    군,시,도에 따른 주소컬럼을 모두 포함하도록 쿼리를 만들어야하지만,

    해당 주소 컬럼에 포함되는 지역데이터가 엄청나게 많이 존재하기 때문에 난감해진다.

    Mysql에는 R-tree를 이용한 위치기반 인덱스를 사용할수있는 기능이 있지만,

    사용하는 PostgreSql에는 디플리케이트가 되었고,

    GiST인덱스가 그 자리를 차지하고 있었다.

    어차피 개념은 비슷하지!

    개념은 2차원 좌표 데이터를 통해, Box, Circle등의 반경 Bounding에 포함되는 좌표를 인덱스를 통해 빠르게 찾는 방법이다.

    이게 Box, Circle등 Bounding의 형식에 따라 오차가 날수도있긴하지만,

    평균값이나, 통계정도로 사용하는 목적이라면,

    데이터를 직접 모두 인덱싱하여 찾아서 계산하는 방법보다, Gist인덱스를 통하여 계산하는 방법이 훨씬 빠르고 간편하다.

    이렇게 되면, 군, 시, 도등으로 확장하며 통계를 계산하기에 훨씬 유리할듯 쉽다.

    예전에 캠핑앱을 만들적이 있는데,

    내 반경 X킬로 안에 위치하는 다른 캠핑장 찾는 기능을 만든적이 있는데,

    이때, 아주 힘들게(?) 구현을 했던적이 있는뎅 ㅠ

    위치주소를 통해, 경도,위도값을 구하고, 해당 경도,위도를 X^2 + Y^2 루트를 통해 직선 거리를 계산하는 방법으로 직접 만들었었는뎅 ㅠ

    Gist기능을 알았고, 이용했으면 쉽게 해당 기능을 구현했었을듯해서, 아쉽긴하다.

    해당 기능이 단순 기능이라서가 아니고, 인덱싱 데이터로 데이터베이스에 저장되고, 해당 위치에 대한 범위를 해당 인덱싱 데이터를 이용해서, 데이터를 찾기 때문에, 레인지 인덱싱을 통해 빠르게 계산이 가능하기 때문이다.

    참고) sql explain시  인덱싱 빠른 type 순서

    system -> const -> eq_ref -> ref -> index -> all

    역시.. 계속 배워야해..(멈추면 썩는다..)

    요즘 전에 읽었던 Mysql책을 다시 읽고있는데..왜 처음 읽는 느낌일까? 

    (그래도 의외로 기억이 새록새록 나기도 하고, 동작하는것도 잼있고 하다.)

    Real MySql 8.0이라는 2권으로된 책인데, 참 내용이 쉽고 좋다.

    (2권은 전에도 안읽어도될듯해서 안읽었는데, 이번에는 2권도 한번 읽어봐야징)

  • [개발생각] 앱에서 한페이지에서 API를 많이 호출할때 튜닝

    프로젝트의 막바지(?)에 프론트와 서버간의 API호출에 대한 튜닝을 한참했다. 여기서 아이디어가 하나 떠올랐다!

    프론트와 서버간의 API호출을 튜닝을 진행할때 진행한 내용은 아래와 같다.

    1) API를 중복하여 호출하는 부분은 줄인다.

    2) A API와 B API의 응답이 포함관계에 있는지 확인하고,포함하는 API 하나만 호출하도록 줄인다.

    3) A,B,C API를 하나의 묶음 API로 내려줄수있다면, 신규 API에  A,B,C 응답을 함께 내려주게하여, API호출을 줄인다.

    4) 한화면에서 여러개의 무거운 API를 호출해야할때, API의 호출을 줄인다.

    4번이 이번에 이야기할 내용이다.

    1) 2) 3)번에 해당이 되지않고, 필연적으로 한화면에서 여러개의 API를 호출해야하는경우, 특히 차트나 그래프, 통계 데이터를 화면에 표현하기 위한 API이고, 해당 API가 무거운 API일때 (쿼리, 프로세스가 복잡한 경우)

    어떻게 튜닝을 해야 할까? 라는 생각을 해봤다.

    그때!! 떠오른 아이디어가 있다!

    만약 차트,그래프등이 화면에 스크롤이 생기는 경우라고하면, 화면에 해당 영역이 보여질때, 해당 화면에 필요한 API를 호출하는 방법을 사용하면, 해당 화면에 들어왔을때, 스크롤 맨아래(유저가 보지않는 영역) 영역까지를 그리고 위해서 API를 모두 호출하지 않아도 되지 않을까?? 라는 생각이였다.

    React보다 Vue를 개인적으로는 더 선호해서(개인적으로 쉽게쉽게 사용하기는 더 편하다ㅎ), 우선 화면에 영역이 그려지는 이벤트를 받을수있는 방법이 있는지를 찾아봤다.

    특정 컴포넌트가 화면에 보일때, 이벤트를 받을수있는 IntersectionObserver라는 기능이 있었다.

    (vue가 있으면 다른 프레임웤은 당연히 있겠지 ㅋ)

    <template>
      <div ref="target">
        사용자 목록
      </div>
    </template>
    
    <script setup>
    import { ref, onMounted, onBeforeUnmount } from 'vue'
    
    const target = ref(null)
    let observer
    
    const loadData = async () => {
      console.log("API 호출")
      // await axios.get(...)
    }
    
    onMounted(() => {
      observer = new IntersectionObserver(
        async ([entry]) => {
          if (entry.isIntersecting) {
            await loadData()
    
            // 한 번만 호출하려면
            observer.unobserve(target.value)
          }
        },
        {
          threshold: 0.1 // 10% 보이면 호출
        }
      )
    
      observer.observe(target.value)
    })
    
    onBeforeUnmount(() => {
      observer?.disconnect()
    })
    </script>

    챗GPT에게 예제하나 만들어봐 해봤다!

    이렇게 IntersectionObserver를 이용하면 화면에 컴포넌트가 어느정도(퍼센트) visible 될때를 이벤트로 받을수있고,

    이때 해당 컴포넌트에 필요한 API를 호출하게하면, 초기부터 스크롤아래 보이지않는 컴포넌트를 위한 API들까지 초반에 호출하지 않아도 되어서, 성능상으로 이점을 얻을것같다.

    우선, 해당 방법을 이미 앱개발, 프론트개발에서 적극적으로 서비스 프로덕트에 사용하지는 모르겠다.

    그리고 여러 해결해야하는 이슈가 있는지도 모르지만, 

    충분히 디벨럽해볼만한 생각이지 않을까?

    생각이 든다.

  • [개발생각] API와 앱의 출시 마무리 작업

    프로젝트의 마무리시 꼭 해야하는 작업이 있다. 바로 폴리싱작업이라고 해야하나?!

    개발중일때, 특히 프로젝트의 마무리시점까지는 엄청나게 바쁘다.

    우선 일정을 맞춰야하고, 그에따른 미진한 개발을 진행해야하기 때문이다.

    따라서, 여러 멤버들은 엄청나게 바쁘고,

    그에따라 이 기간에는 서로간의 커뮤니케이션이 현저하게 낮아지게 된다.

    (사실 이건 명약이 없다…)

    물론, 이 현상이 잘못된 현상이긴하지만, 자연적인 현상이기도 하다고 생각한다.

    (훌륭한 프로젝트 멤버들이나, 아니거나, 빅테크나 아닌 조직이나, 동일하게 나타나는 현상같으니..

    사람이 하는일에서는 나타나는거 같다가 맞을듯? ㅋ)

    이건 어디서나 필연적으로 나오는 현상같다. 

    잘못된것이라고는 생각하지 않는다는 말이다.

    그런데, 멤버간의 커뮤니케이션이 줄어들어게되면, 소통부재로 오는 가장큰 문제중에 하나가, 

    각자가 진행하는 개발이, 중복개발되는 부분이다. 

    다른 멤버가 이미 개발한 부분을 재사용할수있음에도 소통부재로 또다시 개발을 하는 부분이 발생하게 된다.

    프로젝트 막바지에는, 이런것들을 하나하나 파악하며 개발할만한 여유가 없기때문이다.

    스크럼이나 팀회의를 통해 파악이 가능하기도 하지만, 세부적인 개발스펙을 공유하지않고서는,

    분명 이런 문제가 발생한다.

    따라서, 누군가가 이런 부분에 대해서는 총대를 메주는 역할을 해주는게 좋다.

    그 사람은 주니어들은 사실 힘들고,

    내가 맡은 일을 충분히 스케줄링하면서, 이런것도 틈틈히 봐줄수있는 전체 설계나 구조를 빠르고,

    정확하게 파악가능하고, 알고있는 사람이 역할을 해주면 좋다.

    시니어 개발자, 또는 개발리더가 이런것들을 챙겨주면,

    멤버들은 부담이 줄어들수있어서 많은 도움이 된다.

    프로젝트의 마무리 단계에서, 시니어 선배개발자들이나, 프로젝트 리더가 챙겨야하는 것중에 하나인것이다.

    서버 API들의 정리, 앱개발에서의 중복호출, API들의 통합, 중복된 API의 정리 이런것들을 잘해주면,

    프로덕트의 퀄리티가 훨씬 올라갈수있다.

    눈에 띄지는 않는 역할일지라도, 프로젝트에서는 큰 역할중에 하나이다.

    시니어 개발자는 경력이 많은 개발자를 말하는것이 아니라고 나는 생각한다.

    1년 경력을 가지고 있더라도, 저런 마인드를 가지고 있다면 시니어 개발자라고 불릴만 하고,

    10년 20년 경력을 가지고 있지만 저렇게 행동하고 희생하지 않는 개발자라면, 시니어 개발자라고 불릴만한 자격이 없다.

    주니어,시니어는 경력이 아닌, 개발에 대한 책임감과 그에 따른 태도가 성숙한 사람으로 구분지어야 한다고 생각한다.

    (재수없을수도 있지만, 책임감과 개발에 대한 마음가짐으로 판단한다면, 나는 시니어 개발자라고 확신적으로 말할수있다…)

    당신은 시니어 개발자 인가요?

  • [개발생각] 공포의 주간랭킹 개발하기

    프로젝트에서 주간랭킹을 개발해야했다…이게 공포가 될줄이야… 생각할께 너무 많아서 머리가 아픈적은 처음이네 ㅠ

    여러 이벤트를 이용해 경험치를 유저가 획득하고,

    주간으로 획득한 경험치 순으로 주간 랭킹을 구해야 한다는 개발요건이다.

    (쉽지??…ㅎㅎ)

    그런데… 여기서 끝나는게 아니고,

    조건이 몇가지 더있다!!!

    1) 회원 전체 대상 랭킹이 아닌, 소규모로 그룹을 나누고 그 그룹안에서의 랭킹.

    2) 소규모 그룹을 나누는 기준은 랜덤.

    3) 해당 기준은 주마다 매번 달라야함 (즉, 주마다 랜덤을 섞여야함)

    이렇게 3가지 조건이다.

    물론, 단순하게 생각을 하면 뭐 이게 뭔 고민을 할꺼리인가? 라고 생각할수도있다.

    하지만, 이 기능은 고민을 하지않고 만들게 되면, 큰 성능상의 문제를 발생할 여기가 다분하게 있다.

    우선 단순하게 생각하면)

    전체 회원 대상으로 주의 시작시점에 배치로, 그룹을 지어주고, 해당 그룹정보를 테이블로 가지고 있으면, 깔끔하게 동작하긴한다.

    여기서 문제가  발생한다…

    만약, 회원이 늘어서 10만, 20만, 100만이 되면, 그때는 그룹을 실제로 생성하여 테이블로 스냅샷을 떠서 사용하는 방식은

    성능상으로 문제가 발생하게된다.

    주마다 100만명의 소그룹 정보가 쌓이게되고, 주의 시작마다 100만명을 대상으로 스냅샷을 만들어야 하니,

    비효율적이다.

    어떻게 해야할까? 생각을 해봤다.

    스냅샷을 만드는 방식이 아닌,

    쿼리를 통해 실시간으로 그룹을 정해서 소규모그룹리스트를 바로 뽑을수있는 방식을 고민해야겠다고 결정했다.

    그러기 위해서는 몇가지 상수의 결정과 조건의 정리가 필요했다.

    1) 유저별 유니크한 상수값이 있어야 한다. 

    – user_id를 사용하기로 결정했다. (해당 값은 자동증가하고 유저별 유니크한 값이기에 겹칠일이 없는 유니크한 상수이다)

    2) 해당 주안에서는 변하지 않고, 주가 지나고 다음주에서는 변하는 값이 있어야 한다.

    – year + weekOfYear을 조합하여 사용하기로 했다. (년도와 년안에서의 주의 차수를 조합하면 같은주안에서는 같은값이고, 다른주안에서는 다른값으로 변한다.) -> 이게 핵심이다.

    3) 그룹의 회원을 섞는 방식이 있어야 한다. (랜덤값을 만들어야한다)

    – user_id와 year와 weekOfYear값을 OR연산한 값을 md5 hashing한 값을 사용한다.

    – 해당 값으로 그룹의 회원을 매주마다 다른기준으로 섞기위한 기준값을 만들수있다.

    4) 어떻게 그룹핑을 할것인지 기준방식이 있어야 한다.

    – 모듈러 연산을 이용한다. 위 3번에서 구한 md3 hasing값을 모듈러 연산을 통해, group_id를 구하고, 해당 group_id가 같은 유저별로 그룹을 만들도록 한다.

    쿼리는 아래와 같이 사용한다.

    select *
    
    from  user
    
    where
    
        abs(md5(user_id or year or weekOfYear) % 100 = :group_id
    
    order by exp_point desc

    여기서 핵심은 group_id를 쿼리를 통해서가 아닌 코드상에서도 구할수 있어야 한다는것이다.

    즉, 사용자가 앱에 들어오면 해당 사용자의 user_id를 이용해서 group_id를 코드로 구한다.

    그리고 위 쿼리에서 group_id로 넘기면, group_id로 그룹핑된 사용자들 리스트를 구할수있기 때문이다.

    모듈러 연산의 100은 전체 회원을 100개의 그룹으로 나눈다는 의미이다.

    따라서, 전체 회원수를 구하면 전체회원수를 몇명정도로 그룹지울지를 계산하여 100이라는 기준값을 정하면,

    좀더 정교하게 그룹수를 지정할수도 있다.

    우선 기본 설계는 이렇게 마무리 했고, 정상적으로 잘동작하는것도 확인을 하였다.

    스냅샷을 유지하지않고, 바로 주마다 달라지는 소규모 랜덤 그룹을 쿼리만을 통해, 조회할수있게 되었다.

    이제는 쿼리의 튜닝 (인덱스를 잘타게 하는 방식)과 그룹핑된 리스트를 캐싱하여,

    재사용하는 방법만 더하면,

    얼추 구현이 완료될듯하다…

    ㅠㅠ 힘들었는데, 이런걸 고민하고 설계하는 맛이 또, 개발자의 맛이지 않을까?!! 

  • [개발생각] 블리자드..이래서 망한건가???

    주말에 스타크래프트, 와우, 오버워치로 유명한 블리자드에서 Battle.net API를 제공하는것을 알았다.

    OAuth2 API로 구성되어있고, 다름 데이터가 많아서,

    랭킹 리스트와 프로필등을 한눈에 볼수있는 서비스를 하나 만들면 어떨까?하고 API의 연동을 시도해봤다…

    그런데!!!

    글로벌기업, 그리고 한떼는 모든 게이머들에게 선망의 대상이었던,

    갓 블리자드가 API를 이렇게 만드는게 현실인가??? 라는 생각이 들기 시작했다.

    우선 API는 문서가 없다.

    문서라고는 api url들과 필요한 요청파라미터만 기술되어있다.

    해당 API의 응답 필드가 문서로 정리되어 제공하고 있지않아서, 직접 API를 호출해보고, 응답값을 보고, 유추하여 사용해야한다 ㅠㅠ

    (하… 내가 알던 블리자드 맞나???)

    https://community.developer.battle.net/documentation/starcraft-2/community-apis

    (여기 API문서 페이지 인데..한번 보시라..)

    그리고 더 충격적인것…

    API의 응답필드의 코드컨벤션이 모두 다르다..

    ladderId -> 카멜케이스

    memberCount -> 카멜케이스 

    access_token -> snake케이스

    token_type -> snake케이스

    필드마다, 카멜케이스, 스네이크케이스가 혼재되어있다..

    한참을 jackson json변환이 에러가 나서, 봤더니…

    필드마다 다틀려…ㅠㅠ

    결국, 필드, DTO별로 @JsonProperty, @JsonNaming을 이용해 한땀한땀 필드마다 설정을 하여, 변환을 해야했다.ㅠ

    그리고 경기전적데이터 같은 경우는 지속적으로 시간이 지남에 따라 쌓이는 데이터기때문에, 페이징이 필수로 있어야한다.

    한번에 전체데이터를 응답받는것은 네트워크 비용이나, 사용자의 응답속도에 영향을 미치기 때문이다..

    하지만, 그런것 따위 없다.

    그냥 전체 데이터…. (2015년인가?? 스타2 발매된게.. 그때 부터 했던사람은 2015년부터 전적이 응답으로 모두 내려간다…이거 응답데이터(전적데이터)만 10메가는 될듯…ㅠ)

    당연히, 필터조건도 없다..

    페이징조차없는데 필터조건이라고 있을까?

    그나마 제공하는 API는 클라이언트가 사용을 하라고 만든건지, 그냥 구색맞추기로 하라고 해서, 그냥 만든건지를 모를정도로,

    클라이언트의 요구가 반영이 되어있지않는게 대부분이다…

    (차라리 만들지를 마라!! 이놈들아)

    요즘 API를 많이 만들고 있는데, 매번은 아니라도,

    마음가짐은 클라이언트(프론트개발)에서 좀더 편하게, 또는 복잡도가 없게 API를 제공한다는 마음가짐으로 만들고 있는데, 

    저런것들을 보면, 참 한심스럽다..

    최대한 API는 컨벤션이 통일되어야하고, 해당 API를 실제로 사용하는 클라이언트들이 실제로 사용가능하고 유용한 구조로 응답이 내려가도록 API를 구성해야한다는걸 명심해야 한다.

    경우에 따라서 클라이언트에서의 복잡도를 낮추기 위해서,

    서버단에서의 어그리게이션이나 트랜스폼작업을 추가로 해주는 인지상정도 갖춰야한다.

    (너무 빡빡하게 이건 너의 영역, 이건 내가 해줄것!! 따지지 말자)

    울며겨자먹기로…써야하나…ㅋㅋ

  • [개발생각] AI시대에 프로그래머로 사는법?

    예전에는 프로그래머의 실력을 가늠하는 기준중에 하나가 경험에서오는 노하우, 그리고 지속적인 스터디를 통한 지식으로 확연하게 실력을 가늠할수있었다.

    예외인경우도 있었지만, 연차가 그 개발자의 실력을 가늠해주는 척도로 자주 사용을 했었다. 

    (짬밥 어디안간다!! 이런 느낌이지..ㅋ)

    이런 연차를 무시못하는것이 연차만큼 여러 문제글 경험하고, 해당 문제를 해결하기위해 노력했던 사람이라면,

    그 노하우가 무시못할 지식이기 때문이다.

    이런 경험들이 쌓이면, 일부 예언도 가능하다

    (이건 아마 이래서 문제가 있을꺼야 같은 예언…)

    예전에 윈도우 개발을 할때도, 레퍼런스가 많이 없어서, 커뮤니티를 수없이 들락거리며, 질문하고 답을 얻으며 개발자로서 시간을 보냈다.

    문제를 당면하고 그 해답을 얻는 방식이였기 때문에, 해당 문제에 대한 깊은 고민을 많이 했었다.

    “이건 왜 이런 문제가 발생하지?”

    “이거 혹시 이래서 일까?”

    여러 생각도 하고 가설도 세우고 실제로 테스트도 하면서 문제의 범위를 점점 좁혀갔고, 마지막까지 그물망이 좁혀지고 나서는 어김없이 버그의 원인을 확신하고 알수있었다. 

    이런 과정의 학습때문일까?

    어떤 문제가 발생했을때, 문제를 해결하기위한 과정에 익숙하다.

    API의 호출을 보고, 에러가 난다면, 에러로그를 찾아보고, 해당 에러 로그를 통해,

    문제를 유추하고 범위를 줄여서, 문제의 원인을 찾는다.

    원인을 찾았으면, 코드를 수정하고 테스트한다.

    어떻게 보면, 너무나 기본적인 과정이고, 군더더기 없는 과정이지만, 

    요즘 개발자들은 이런것에 익숙하지 않은 사람들도 꽤있는것 같다.

    AI에게 물어보면, 너무가 친절하게 답을 해주니, 로그를 찾고, 범위를 줄이고, 고민을 할 필요가 없는것 같다.

    디버깅을 어떻게 하는지 모르는 개발자가 많다는 것이다.

    AI를 통해 나오는 코드 더미를 아무 의심과 검증없이, 프로젝트 코드에 적용하거나,

    AI가 답해주는 버그 원인을 철석같이 믿고, 해당 문제를 해결했다고 생각하거나,

    동료 개발자의 의견보다는 AI의 답변을 더 신뢰하거나..

    너무 답답하다. 제발 AI가 작성해준 코드 이해하고 적용을 좀 하자…

    AI 바이브 코딩을 하는것이 대세이고, 하지않는 개발자는 시대에 뒤쳐져가는 것처럼 보인다.

    맨날 나오는 소리가 

    “저 코딩 하나도 안하고, 하루만에 앱하나 만들었어요”

    “제미나이가 다 코드 작성해줬어요”

    이딴말…

  • [개발생각] JPA에서 soft delete 관리하기

    JPA에서 soft delete관리를 어떻게 해야하나를 고민했었는데.. 방법이 있었네 ㅠ 

    진행하는 프로젝트에서 jpa에서 row delete를 할때, soft delete방법을 사용하고 있다.

    delete_dtm필드가 null인지 아닌지에 따라 삭제여부를 판단하여 사용하는것으로,

    delete로 실제 row를 삭제하지 않는 방법을 사용한다.

    (이부분은 여러 장점이 있기에 이렇게 하기로 결정했다.)

    그런데 하나 귀찮은점이 있다.

    바로 항상 조회시 deleteDtm is null을 붙여야 실제 삭제되지 않은 값을 가져와서 사용할수있기에,

    아래 JpaRepository와 같이 항상 조건에 DeleteDtmIsNull스펙을 넣어야한다.

    fun findAllByDeleteDtmIsNull() : List<User>

    fun findOneByUserIdAndDeleteDtmIsNull(userId:UserId) : User

    비즈니스로직에서는 삭제되지않은 라이브 데이터를 사용하기에 거의 모든 스펙에서 위와 같은 “DeleteDtmIsNull”가 포함된다.

    이걸 프로젝트에서 매번 넣어주게해서 사용했는데..

    쉽게 이 부분을 관리할수있는 기능이 따로 있어서 정리를 한다.

    @Entity
    @SQLRestriction("deleteDtm is null")
    @SQLDelete(sql = """
        UPDATE users
        SET deleteDtm = now()
        WHERE id = ?
    """)
    class User {
       @Id
       val id:Long;
       val deleteDtm:LocalDateTime;
    }


    val users = userRepository.findAll();
    
    userRepository.delete(user);

    findAll하면 자동으로 deleteDtm is null 조건이 붙는다. (엄청 편하다!!!)

    delete기본 함수를 호출하면, 실제 row삭제대신 deleteDtm이 업데이트 된다 (@SQLDelete)

    위 방법을 사용하면, 훨씬 간결하게 jpa를 관리할수있다.

    아래는 알아두면 유용한 몇가지 정리해 본다.

    readOnly전용 Jpa인경우는 아래와 같이 @QueryHint를 추가하면, DirthCheck를 하지않아 성능상의 이점을 가져갈수있다.

    @QueryHints(
        @QueryHint(
           name = "org.hibernate.readOnly",
           value = "true"
        )
    )
    fun findAllReadOnly():List<User>

    그리고 가장 중요한것, 어드민만들때 보면, 조회시 여러 조회조건을 통해, 쿼리를 수행해야하는 경우가 있다.

    이경우, 쿼리가 종류별로 나오거나, 다이나믹 쿼리를 사용하거나 하는데, 상당히 유지보수에서 좋지가 않다.

    이런경우, Specification을 사용하면, 훨씬 동적 쿼리를 관리할수있게 기능을 만들수있다.

    interface UserRepository :
        JpaRepository<User, Long>,
        JpaSpecificationExecutor<User>
        
    
    object UserSpecs {
    
        fun ageGreaterThan(age: Int?): Specification<User> {
            return Specification { root, _, cb ->
                age?.let {
                    cb.greaterThan(root.get("age"), it)
                }
            }
        }
    
        fun nameLike(name: String?): Specification<User> {
            return Specification { root, _, cb ->
                if (name.isNullOrBlank()) {
                    null
                } else {
                    cb.like(root.get("name"), "%$name%")
                }
            }
        }
    }
    
    
    val spec =
        Specification.where(UserSpecs.ageGreaterThan(20))
            .and(UserSpecs.nameLike("kim"))
    
    val users = userRepository.findAll(spec)

    이렇게 spec을 통해, 조회 조건을 동적으로 구성할수있고, 해당 조건을 쿼리문이 아닌,

    코드베이스로 관리할수있어서,

    재사용및 유지보수가 띄어나게 된다. (이 기능은 사실 미쳤다.. )

    이 기능은 나도 잘사용해보지 않은것이라, 어드민등에 조건이 많은경우에 적용하면 참 유용하겠다 🙂

    물론, 가장 강력하다고 생각하는건 QueryDsl (또는 Kotlin JDSL)을 사용하는게 가장 강력한 동적쿼리 사용법이겠지만,

    간단한 경우나 좀더 커스텀을 하고싶은경우에 따라서는 Spec구현 방식이 더 깔끔할수도 있다고 생각된다.

    (결국, 용도에 따라 적절하게 사용하는것으로 마무리..ㅎ)

    그나저나, 프로젝트에 @Query에 JPQL쿼리가 너무 많이 들어가있는데..

    특히 DTO로 프로젝션하는 쿼리들, 조인쿼리들…관리가 어려울듯한뎅;;

    Kotlin JDSL로 한번 바꾸긴해야겠다…

    (JDSL사용하면, 정말 깔끔하지긴 할듯하다!! – 클래스패키지 정의 없어지는것만 해도 ㅠ)

    Kotlin JDSL가 장점이 많아서, 안쓸이유가 없으니..

    (마치 코틀린 한번 사용하면하면, 자바 못쓰는 느낌?!)

    틈나는데로 적용을 해봐야겠다. (고칠부분이 많겠구나..ㅠㅠ)

  • [개발생각] 시스템의 정리 – 코드 컨벤션과 분류

    요즘은 좀 집착하는게 있다, 컨벤션과 분류라고 해야할까?

    현재 진행하는 프로젝트가 아무래도 오래된 년차가 있는 시스템을 신규로 개발을 해야하는 프로젝트다보니,

    기존의 레거시 시스템을 우선적으로 파악해야하는 경우가 많다.

    (레거시를 파악하고 이해해야, 신규 시스템도 만들수있으니)

    여기서 어려운점이 무엇이었냐하면 (아직 프로젝트는 끝나지 않았지만..ㅎ)

    기존의 시스템,서버들, 즉 인스턴스들의 분류가 명확하지 않고, 관리가 잘안되는 느낌이었다.

    인스턴스들이 동작하고 있는 정보를 한눈에 볼수가 없고, 파편화되여, 여러서버들에 인스턴스가 떠있는 느낌이 들었다.

    따라서 명시적으로 어떤 기능이 어떤 서버에 몇개의 인스턴스로 동작하는지를 파악하는게 어려웠고,

    파악을 하더라도, 이게 정확한것인지를 확신하기가 어렵다는 것이였다.

    이부분을 개선하기위해서,

    인스턴스서버들을 한곳에서 볼수있도록 구성을 해야겠다고 생각했다.

    특히, 배치서버들이 너무 베일에 감춰진 느낌이 컸기때문에, 해당 배치서버들을 Airflow 스케줄러쪽으로 모았다.

    모음과 동시에, 해당 인스턴스들의 기능과 역할에 따라 분류를 다시 했고,

    비슷한 일, 역할을 하는 놈들끼리를 그룹핑하여 관리하도록 구성했다.

    (이런 정리된 내용을 위키등에 정리하는것과는 별개로, 시스템내에 명기하는 방법을 생각함으로써, 좀더 최신의 데이터라는 느낌을 주도록 고민했다)

    개인적인 편견일수도있지만, 위키내용은 뭔가 믿음이 안간다…

    이거 관리가 되는 페이지인가??를 매번 생각하게 되서…ㅎㅎ

    이런 고민은 아래와 같이 해결했다.

    Airflow에는 스케줄을 등록할때는 (DAG등록) 한글로 Job타이틀을 등록하여 관리하도록 룰을 정했고,

    해당 잡의 성격을 알수있는 표준화된 태그를 추가하여,

    어떤 성격의 기능인지를 더 명시적으로 파악할수있도록 하였다.

    예)

    [배치] 유저탈퇴시 배치처리_#1
    #exe_crontab, #src_kafka 

    위의 의미는 ‘유저탈퇴시 배치처리하는 잡으로 #1 첫번째 잡이라는 뜻’

    #을 통해 첫번째잡, 두번째잡으로 표시한것은 배치를 샤딩해서 여러개를 구동할수있기에,

    해당 샤딩 인스턴스를 표시하기 위한 룰로 정했다.

    그리고 태그의 exe_crontab는 실행방법은 크론탭 스케줄링으로 동작한다는 의미이며,

    src_kafka 태그는 해당 트리거는 kafka큐를 통해 트리거된다는 의미이다.

    이렇게 표준화된 태그들을 여러개 정의하고 만들어, 태그를 추가하여 해당 잡의 성격을 태그로 파악할수있게 했다.

    이렇게 잡의 한글 타이틀명과 태그를 잘정리해서 잡을 등록해두면,

    처음 접하는 신입 개발자라도 충분히 해당잡의 특성과 역할등을 쉽게 알수있을것이다.

    두번째 개선 포인트는 아래와 같다.

    레거시 시스템에서는 필연적으로 많은 개발자들이 거쳐가며 개발을 하고,

    오랜시간동안의 코드의 수정과 추가가 있음으로 해서, 코드 컨벤션을 엄격하게 관리하지 않으면,

    각양각색의 코드 컨벤션들이 존재하게 된다.

    이부분은 가장 경계해야하는 부분이다.

    나하나쯤이야, 이렇게 한다고 크게 문제가 없을듯한데? 라는 생각을 가진다면, 그 생각은 큰 문제를 야기한다.

    코드 컨벤션은 모두가 꼭 지켜야하는 팀내의 룰이다.

    이 룰을 지키지 않는다면, 저마다의 방식과 표현이 프로젝트에 녹아들게 되고, 이런 균열들은 결국은 컨벤션에서 끝나지않고,

    설계의 레이어에 대한 룰을 지키지 않게 되고, 코드의 역할과 경계에 대해서도 개인적인 생각이 녹아들어가게 된다.

    큰댐에 금이 가기 시작하는 느낌이랄까? 작은 실금에서 균열은 시작되니…

    따라서 팀원들은 약속된 코드 컨벤션을 꼭 지키도록 해야하고, 지켜야하는것을 책임이라고 생각하여야 한다.

    코드 컨벤션은 이런 의미에서 정말 중요하다.

    팀원들의 멘탈의 수준을 다잡아주는 역할로써 매우 중요하다고 생각하기 때문이다. (헤이해지는건 순식간이다!!)

    코드 컨벤션 안지키는 팀치고 잘굴러가는 팀 못봤다..쩝

    (이전 직장에서는 api url 표기법을 _로 룰을 정했었는데, 신입 개발자가 – 하이픈으로 표기법을 작성해서 난리가 난적이 있었지..ㅎㅎ)

    긴급 개발자 회의가 소집이 될정도였어서, 정말 큰 이슈로 바라보긴했다.

    (뭐 그당시에는 누가 이렇게 했냐!!! 정도였긴했지만, 위 내용처럼 훨씬 큰 빙산의 일각이 있다고 생각한다.)

    이부분은 룰을 지속적으로 모니터링하며, 잘못된 부분은 팀원들끼리 인지하도록 하는 방법이 가장 효율적인것같다…

    자동화가 안되는 느낌 ㅠ

    하지만, 잘못됨을 팀원들이 잘 받아들이고, 능동적으로 개선하면 최첨단 수동이 되는 가장 좋은 방법이기도 하다!!