어플리케이션 레이어의 요청 DTO의 필드에 도메인VO를 사용해도 되지않을까?
Email이라는 도메인 VO를 만들고, 해당 VO안에 벨리데이션로직도 구현했다고 한다면… 그걸 어플리케이션 레이어의 요청 DTO에 필드에 사용해도 되지않을까?라는 생각..
어플리케이션 레이어의 요청 DTO의 필드에 도메인VO를 사용해도 되지않을까?
Email이라는 도메인 VO를 만들고, 해당 VO안에 벨리데이션로직도 구현했다고 한다면… 그걸 어플리케이션 레이어의 요청 DTO에 필드에 사용해도 되지않을까?라는 생각..
다른 방식으로 동작하는 동일한 역할을 하는 API는 깔끔하게 도메인 레이어에서 제거하는게 더 깔끔해진다.
도메인 주도 설계 개발을 하게 되면, 아래와 같은 상황이 올때가 있다.
예를 들면,
ci를 넘기면, 그 ci의 주민등록상의 주소를 리턴해주는 API를 연동한다고 해보자.
그런데, 해당 API는 불안해서, 또는 다른 이유로 같은 기능을 제공하는 몇개의 다른 API를 보조로 사용하려고 한다.
(A api 죽으면, B api 사용,)
그런데 각각의 A, B API는 응답을 주는 방식이 틀리고, 요청파라미터도 다르다.
하나는 요청하면 바로 응답값을 주는 동기방식이고, 하나는 요청하면, 콜백URL을 통해 나중에 전달해주는 콜백 비동기 방식이다.
이런경우, 도메인 서비스에서 비즈니스 로직을 구현할때,
해당 api호출을 제공하는 도메인 Client 인터페이스를 만들고, 구현체는 인프라스트럭쳐에 구현체를 구현하고,
해당 도메인 Client 인터페이스를 도메인 서비스안에서 로직에 포함하여, 구현을 해야할까?
A,B api 요청/요청 파라미터는 어차피 동일한 역할을 하기에,
정규화하는 방법으로 요청/응답 파라미터는 도메인 Client 인터페이스에서 표준화하여 정하고,
나머지 api별 개별 파라미터는 map을 통해 추가로 전달받도록하여 어찌저찌 맞춘다고 해도…
(물론, 깔끔한 방법은 아니지만)
(코틀린같은 경우는 typealias를 이용해서, 적어도 개발자에게는 map으로 코드상에 표현하지 않고 의미를 부여할수있는 이름으로는 정의할수있으니…)
typealias AdditionalApiParam = Map<String, String>()응답방식이 동기방식, 콜백방식은 사실 도메인 서비스에서 도메인 Client 인터페이스만 가지고 일반화하여 로직을 구현하기는 어렵다.
등기방식을 억지로 콜백방식으로 변형하여, 사용하는 방법이 있긴하지만,
(동기api에서 받은 응답값을, redis등의 캐시에 담아두고, 쓰는곳에서는 key를 통해 응답값을 꺼내쓰게 맞추면, 얼추 맞출수는 있다)
– 동기를 비동기로 굳이 만들어서 사용하는 느낌이랄까?
– 상당히 찜찜하다. 이렇게 까지 해야하는가? 라는 생각…
api가 언제 또 다른 방법으로 바뀔수있다고 한다면, 더더욱 맞추기가 어렵다.
이런경우는 깔끔하게, 도메인 서비스 영역에서,
과감하게, 도메인 Client 인터페이스의 사용한 로직을 제거하고, application레이어에서 도메인 Client 인터페이스를 수행하고, 응답받은 값을 도메인 서비스로 파라미터로 전달받는 방식으로 수정을 하는게 좋은것 같다.
api가 어떤 방식이던, application에서 호출해서 응답값을 도메인 서비스로 파라미터로 전달하게 구조를 만들면,
그 순간부터는 도메인 서비스는 도메인 Client 인터페이스의 방식/방법에 연결고리에서 벗어날수있게 되기때문이다.
분명, 개발자라면,
동일한 api의 인터페이스를 정하고, 해당 인터페이스를 도메인 레이어로 가지고와서, 공통된 비즈니스로직에 녹이려는 욕심이 분명 있다.
잘만들면, 엄청 깔끔하게 되고, 재사용성의 영역이 커지기 때문이다.
하지만, 위와같은 경우는 억지로 도메인 영역으로 도메인 Client 인터페이스를 녹이려고 하면,
오히려 도메인 영역이 구현체의 역할을 하게되는 실수를 범하게 될 확률이 클것같다.
교훈?
도메인 레이어에서의 비즈니스 구현에서, 맞지않는 인터페이스를 꾸겨넣으려는, 욕심은 버리자!!
과감히 버리자!
어플리케이션 레이어가 그 역할을 해준다는것을 기억하자!!
🙂
웹서비스에서 회원구분코드의 정의에 대한 깊은 생각을 했다.
좀더 전문적인 웹서비스를 만들때, 회원이라는 정의는 엄청나게 중요하다.
회원 정의를 엉성하게 설계하면, 결국 회원중심으로 돌아가는 모든 기능과 연결등이 엉성하고 어설프게 설계된다.
개발자는 유연과 엉성의 차이를 명확히 인지하고 있어야 한다.
유연한 설계는 수정에 닫혀있고, 확장에 열려있는 구조가 되지만,
엉성하고 어설픈 설계는 수정에 활짝 열려있고(도둑들아 모두들어오세요~), 확장에 닫혀있는(불났는데 문이 안열려..)
답답한 시스템이 되버린다..
이런 유연한 설계를 지향해야하고, 이런 설계를 위한 첫걸음은 회원에 대한 테이블 설계라고 할수있다.
개인적으로는 경력이 있다보니,
많은 프로젝트 설계/개발 경험이 있었고, 매번 해왔던 회원설계/회원구분에 대한것들에 그렇게 깊게 생각하지않았다.
너무 당연한것 처럼 설계를 하거나, 습관처럼 개발을 한것같아, 지금 생각해보면, 아쉽기도 하다.
왜 이렇게 해야하는걸까? 라는 고민을 많이 하지않았던차에,
이번주에 많은 고민을 했고, 그 해법이 나름 정리가 되어 글을 남겨두려고 한다.
1) 회원원장 데이터를 어떻게 구분하고 저장할것인가?
2) 회원구분코드를 어떻게 정의할것인가?
위 2가지 고민거리에 대한 나름의 해법을 정리해 두겠다. (나이드니, 잊어버릴까봐…무서워..)
1) 회원원장 데이터를 어떻게 구분하고 저장할것인가?
회원원장 즉 기본 User테이블은 최소한의 정보와 서비스내부에서 많이 사용하는 컬럼정도로 가볍게 유지를 해야한다고 생각한다.
기본 User테이블 자체의 용도는
웹서비스에서 자주 접근해야하는 테이블이 될것이며,
온라인 서비스와 더불어 수집/집계등의 배치잡과 같은 빅데이터를 사용하는 쿼리베이스 프로세스에서 기본 join테이블이 될 확률이 높기때문에, 다루는 데이터를 최소한으로 유지하여, 조회에 부담을 줄여주여 한다고 생각하기 때문이다. (성능적 이유)
따라서, 다른 회원관련 정보들은 적절하게 다른 테이블로 구분하여 분산 저장하는 방식이 좋은 방향이라고 생각하고,
조회는 분산된 테이블이 베이스 테이블로 접근하는 방법으로 개발은 이뤄져야한다고 생각한다.
예)
—————————————————-
기본 User테이블
– user_id
– id
– pwd
– status
– dvcd
– reg_dtm
– login_dtm
– delete_dtm
—————————————————-
User 부가테이블
– user_id
– nickname
—————————————————-
이 정도로 가볍게 유지를 하는게 좋을듯하다.
그럼 인증테이블은 어떻게 유지하면 좋을까?
휴대폰인증/신분증인증 2개 인증이 존재한다고 예를 들어보자.
예)
—————————————————-
휴대폰인증 테이블
– user_id
– ci
– phone_num
– real_name
—————————————————-
신분증인증 테이블
– user_id
– residence_id
– birth
—————————————————-
이정도로 테이블 구성을 하면 될듯하다.
2) 회원구분코드(dvcd)를 어떻게 정의할것인가?
회원구분코드의 의도를 명확히 알아야 한다.
회원구분코드는 기본 User테이블에 존재해야하며,
해당 코드는 회원의 모든 구분을 표현하는것이 아닌 (특히, 모든 인증의 단계/회원의 상태를 구분하는식이 아님)
서비스내에서 경계가 명확한 큰개념의 구분으로 구분코드를 정해야한다.
회원구분코드는 기본 User테이블의 사용에서 첫 조회 조건으로 들어가는 조회범위를 결정하는 컬럼데이터가 되기때문에,
세분화보다는 경계가 명확한 개념의 구분코드정도로 정해야한다.
그리고 세분화한 회원의 구분은 위에서 정의한 회원정보를 분리해서 보관해둔 (인증,회원부가정보 테이블등) 다른 테이블들을 통해 구분하도록 설계한다.
특히 주의할것은 회원구분코드와 회원인증수단을 연결하여 모든 단계를 표현하려는 욕심을 부리는것이다.
(회원구분코드를 통해, 이 회원의 상태를 모두 구분되고, 확인할수있었으면 좋겠어!! 라는 욕심)
이부분이 사실 고민의 시작이였긴하였다…ㅠㅠ
회원구분코드로 회원의 상태/단계를 모두 표현하려는 욕심을 부렸더니,
의도치않는 복잡하고/부담되는 방법들을 생각해 내거나 (비트연산같은..나름 아이디어는 좋았지만 ㅎ),
구분코드간의 단계를 만드는 방법을 생각하게 되는 (엄청난 구분코드 갯수),
삼천포로 빠지는 상황이 오게 되었다.
각 인증수단에 대한 단계를 정의하려고 하니,
인증의 순서가 생기거나,
인증의 종류에 따라 dvcd의 종류가 급격히 늘어나는 케이스 또한 발생하였다.
회원 구분코드는 서비스의 경계가 명확한 구분으로만 간단히 정리하는것을 지향하고,
그 이외의 상세한 구분은 인증테이블이나, 부가테이블등 다른 테이블등을 통해 찾을수있는 방향으로 푸는게 좋을것같다는 결론을 내렸다.
이번 주말에는 회원구분코드에 대한 고민을 통해,
도메인 주도 설계에서 도메인만 생각했던 오류에서 벗어나, 그 도메인에 정의된 프로퍼티들도 많은 고민을 해야한다는것을 배우게 되었다.
도메인 주도 개발에서 프로퍼티에 대한 정의와 설계에 대한 이해가 이렇게 중요했다니..
최소한 위의 룰을 지킨다면,
최소한, 내가 만드는 서비스는 엉성하게 연결된 서비스가 아닌, 유연/느슨한 연결의 구조를 갖춘 서비스가 될것이라는 자신감이 있다.
이번 주말은, 오랜만에 설계에 대한 깊은 고민을 해봤던, 좋은 시간이었다.
개발은 역시… 어렵네..
시니어 개발자와 주니어 개발자의 가장 큰 차이는 ‘관심’ 같다.
요즘은 수평문화등의 이유로 개발자들간의 시니어, 주니어 개발자의 역할과 책임의 경계가 모호해진것같다.
수평문화는 참 좋은 문화이지만, 역할과 책임에서도 수평이 되는것은 나는 좋게 보지않는다.
직장,학교,군대등 사람들이 모여 생활하는 집단에서는 역할과 그에 대한 책임의 경계가 명확해야하기 때문이다.
이 부분을 수평문화라는 놈이 경계를 모호하게 만드는것 같긴하다.
그렇다면, 개발에서 역할과 책임이라는 범위로 봤을때,
시니어 개발자는 어떤 사람이고, 어떤 역할을 해야하는걸까?
다수의 경험을 바탕으로, 모든것들을 척척 해나가는 슈퍼맨같은 사람이라고 볼수도있다.
하지만, 나는 다르게 생각한다.
시니어 개발자의 가장 큰 덕목은 ‘관심’이다.
내가 사용하는 기술에 대한 ‘관심’
– 어? 이게 어떻게 이렇게 동작하는거지? 라는 생각. (관습적으로 사용하는 기능/방식도, 그 동작원리를 이해하고, 습득하려고 해야한다.)
– 이렇게 코딩한건 이런 이유때문이야! 라는 생각. (모든 코딩은 그렇게 작성한 이유가 틀릴지언정, 이유가 명확히 있어야 한다.)
– 이런것 흥미롭다, 한번 스터디해봐야지! 라는 생각. (새로운 기술에 대한 갈망이 있어야 한다.)
같이 일하는 주니어에 대한 ‘관심’
– 저 사람은 이 부분에 대해서 어떻게 생각할까? 라는 생각. (나도 틀릴수있다, 다른사람이 어떻게 이해하는지를 항상 비교해야한다.)
– 어떤 부분에서 힘들어하는 걸까? 라는 생각. (선배로써, 힘든부분에 대해서, 해결책을 제시해 줄수있어야 한다.)
– 어떤 부분이 부족한걸까? 라는 생각. (주니어의 부족한 부분을 파악하고, 부족한 부분을 충전할수있는 방법을 제시해야한다)
내가 만드는 시스템에 대한 ‘관심’
– 이렇게 하면 더 좋아질꺼야! 라는 생각. (관습적인 개발을 떠나, 항상 상황에 맞는 아이디어를 생각해야한다.)
– 이부분은 어떻게 개선을 해야할까? 라는 생각. (개발/설계에 대한 이해도와 지식을 쌓아야 한다)
– 왜 이런 설계를 해야하는걸까? 라는 생각. (개발/설계에서는 항상 맹목적으로 받아들이지 않고, 그 이유를 이해해야 한다)
참, 적어보니, 소름끼치는… 꿈같은 이야기를 적어놓은것 같다.
하지만,
충격적인건, 정말 저런 시니어가 많다는것이다. (다만 너의 옆에 없을 확률 99% 🙂 )
실제로, 주니어 개발자 시절에, 이런 시니어 개발자를 2명정도 만난것 같다.
그 시니어 개발자와 함께 일을 하면, 정말 실시간으로 레벨업이 되는것을 느낄정도였다.
한명의 제대로된 시니어 개발자의 영향력은 실로 어마어마하다는걸 몸소 체험했다.
또한, 이런 시니어 개발자와 같이 일할수있는 소중한 시간을 가진다고 해도,
저런 부분을 배우려 하지않는 ‘주니어’ 개발자에게는 ‘전설의 시니어’라도 무의미하다.
결국, 주니어 개발자는 저런 시니어 개발자의 능력을 따라하고, 배우려는 마음가짐이 가장중요하고,
시니어 개발자는 ‘관심’의 덕목으로 좋은 영향력을 끼치는게 중요하다.
결론, 둘다 잘해야 됨 (손벽도 마주쳐야 소리가 나지…)
그리고…나도 더 노력하자…
가끔 Api의 RequestBody로 Map객체를 받아야할 필요가 있다.
Api의 RequestBody의 필드값들이 가변적이거나, 요청에 따라 바뀌는경우등의 케이스에 유연하게 대응하기위해서,
Map객체를 받게 구현을 할때가 있다.
이경우는 사실 코드상에서의 유려한 흐름으로 읽히는 코드는 포기해야한다.
Map<String, Any> req 이런 객체에서 req.get(“name”), req.get(“age”)등으로 꺼내써야 하고,
값이 Any 타입으로 선언되어있기 때문에, 캐스팅도 해야하는 코드가 덕지덕지 붙게 됨에 따라,
깔끔하지 못하고,
개발자가 class로 구성된 DTO와 달리 필드를 바로 확인할수가 없고,
문서나 주석등에 의존하거나 코드 전체를 훝어야 한다….
이런 문제를 문득,
코틀린의 Delegate를 사용하여, Map을 개발자가 읽을수있는 객체로 구현을 해볼수있지 않을까? 라는 생각이 들었다.
바로 구현을 해봤다.
결과는 상당히 만족한다.
( 역시, 아이디어가 떠오르고, 실제 구현했을때, 그 생각대로 구현이 될때, 개발자로써 가장 희열을 느낀다 ^^ )
구현은 아래 (가칭) FlexMap코드이다.
Map객체에 delegate를 만들어 연결해줬고, data class안에 필드를 정의할수있게하고, 해당 필드를 map delegate에 위임하도록 by this로 설정하였다.
그리고 toString()을 오버라이드하여, innerMap이 toString()에 innerMap이라는 필드로 노출되는것을 막았다.
data class FlexMap (private val innerMap:MutableMap<String, Any> = mutableMapOf())
    : MutableMap<String, Any> by innerMap {
    var name by this
    var age:Int by this

    override fun toString(): String {
        return innerMap.toString()
    }
}

fun main() {
    val req = FlexMap()
    req.name = "tommy"
    req.age = 60
    println(req)
}

//결과 : {name=tommy, age=60}
이렇게 구현을 하면, FlexMap을 사용하면, name, age와 같은 필드를 명시적으로 선언하여 사용할수있고,
해당 필드는 자체적으로 innerMap에 위임되어 innerMap에서 값을 찾아서 연결이 된다.
필드로 표현을 할수있기에, 해당 필드에 대해서 다른 델리게이터를 연결하면, 암호화, 필드 검사등을 추가로 할수있다.
(일반 필드에 적용하는 모든것을 명시적으로 동일하게 할수있다)
저 10줄남짓의 코드가 나에게는 엄청난 희열을 주었다.
우리는 요청수를 제한하기위해 RateLimiter을 사용한다.
주로 많이 사용하는 라이브러리로는 Resilience4j인데,
사용법은 결국 초당 몇건(TPS)가 넘으면 요청을 막을래!로 설정을 셋팅하여 사용 한다.
해당 max tps를 설정하기위해서는 성능테스트를 거쳐, 값을 측정하고, 예측에 의한 정적인 max tps를 설정하게 된다.
물론 이 정도의 기능도 상당히 프로덕션 서비스에서는 많이 유용하지만,
그 측정값이라는것이 정확하지 못하고, 여러 노드로 이뤄지거나, 환경이 다르거나에 따라 갭이 상당할수도있다.
이런 경우,
프로덕션 환경에서는 시스템에 부하를 줄정도로 더 요청을 받거나,
또는 시스템을 100% 사용하지 못하는 선에서 요청을 거부하게 RateLimiter가 동작하기도 한다.
이런 부분을 어떻게 잘 설정을 할수있을까? 라는걸 생각해 봤다.
정적인 값으로 설정하는게 아닌,
실제 데이터를 바탕으로 실시간으로 RateLimiter의 max tps를 구하여 적용하는 방법으로 구현을 할수도있지 않을까?
라는 생각을 했다.
우선 시스템의 CPU 로드와 Memory 사용량, 요청 TPS등을 쉽게 구할수있는 Actuator를 사용해서 서버의 지표데이터를 수집한다.
내가 구현하려는 RateLimiter에서는 주기적으로 해당 지표를 모니터링하면서,
실제로 Cpu로드나 Memory가 정해진 측정치까지 도달하는지, 여유가 있는지 여부를 실시간으로 계산한다.
이에 따라,
요청을 더받고, 덜받고를 실시간으로 판단하도록 만들면, 시스템의 성능을 최대한 사용할수있는 RateLimiter가 나오지 않을까 한다.
조만간 능동형 RateLimiter를 직접 만들어볼 생각이다.
1) 시스템 정보 수집 : Actuator
2) 실시간 로그 측정 및 지표 계산 : esper (cep)
3) RateLimiter : Resilience4j를 감싸서 커스터마이징하거나, 여의치않다면, 직접 Aop로 구현을 할생각.
4) 어드민 : 최대 성능을 쉽게 설정하고 모니터링하는 어드민 페이지.
위 4개의 스탭으로 플랜을 세웠다.
이건 LMax Distruptor’s RingBuffer의 개념에서 영감이 떠올랐다.
RingBuffer를 사용하는 여러 이유가 있지만, 시스템의 성능을 최대로 사용하기 위함이 있다는 내용을 읽은적이있다.
Distruptor에서는 링버퍼를 시스템이 여유가있다면, 좀더 많은 일을 시키고 (링버퍼내의 이벤트를 빠르게 소진),
시스템이 여유가 없는 부하상태라면, 일을 대기하거나 조금씩 시키도록 하는데(링버퍼내의 이벤트를 적게 소진), 링버퍼를 활용한다.
RateLimiter도 정적인 값을 미리 설정하고 그값에 의해서 동작하는것보다는
좀더 실시간으로 시스템의 로드를 파악하고 인지한 상태로 좀더 요청을 처리할수있는 상태라면 좀더 요청을 받도록 동작하고,
그 반대라면 요청을 줄여주는 능동형으로 동작하면 더 좋겠다는 생각에서 이런 고민을 하게되었다.
이름은…뭐라고 할까?.. (ReactRateLimiter 정도?! ㅎㅎ)
코틀린에서는 Checked Exception 개념이 존재하지 않는다.
그로인해 모든 Exception은 RuntimeException과 같이 동작하고,
그 가장 큰 수혜라고 하면, 함수간에 Exception을 주고받을 명세 throws Exception 같은 코드들이 없어지는 깔끔함일것이다.
처음에 이 개념을 알고, 좀 혼란스러웠던 경험이 있다.
바로 스프링에서 사용하는 @Transactional의 사용에서 였다.
java에서
@Transactional(rollbackOn = [Exception::class, Throwable::class])이런식으로 정의해서,
Checked Exception인경우도 롤백이 되도록 설정을 하여, 많이 사용했다.
하지만, 코틀린에서는 Checked Exception개념이 존재하지 않고, 모두 Unchecked Exception개념으로 동작한다면,
저 옵션은 없어도 되는게 아닌가? 라는 생각이 문득들었다.
(스프링 트랜잭션은 기본적으로 Unchecked Exception일때만 롤백이 되니까)
상당히 합리적인 의심이라고 생각이 들었고,실제로 옵션을 제거하고, 트랜잭션 롤백 테스트를 해본결과,
Exception발생시, 롤백이 되지않았다.
Transactional 동작은 java에서와 동일하게 동작함을 알았다.
저 옵션이 존재해야한다는것은 테스트를 통해 입증이 됬지만, 왜 있어야하지 라는 생각이 계속 들었다.
(코틀린은 모두가 UnChecked Exception으로 동작하는뎅,,,,)
역시, 궁금하면…코드를 파보아야 겠지..
@Override
public boolean rollbackOn(Throwable ex) {
    return (ex instanceof RuntimeException || ex instanceof Error);
}
스프링 트랜잭션관련 코드를 찾았다..
코드를 보고 깨달았다.
트랜잭션은 스프링에서 코드로 관리하는 스코프이며, 코틀린에서의 Uncheck, Check Exception의 동작은 코틀린 컴파일러의 스코프라는것을…
결국 코틀린에서 컴파일러단에서 처리하는 룰은 별개이며,
스프링에서 트랜잭션을 처리하는 룰은 클래스의 타입을 보고 하는것이기 때문에 전혀 연관이 없다는 것을 알수있었다.
스프링 트랜잭션에서는 단순하게 클래스의 타입을 보고 롤백여부를 판단하기에,
코틀린같은 jvm언어에서 Exception을 어떻게 정의하고, java와 다르게 정의를 하고 컴파일을 하던, 영향이 없었던 것이다.
(트랜잭션에서는 클라스 타입만으로 판단을 하니까!!)
단순히 생각하면, 룰과 구현을 혼돈하고 실수를 할수있을것같다.
룰과 그 룰에서 사용하는 실제 클래스의 구현을 같은 개념으로 동작한다고 혼돈할수있다는것을 깨달았다.
대세는 AI, 이 사실은 거스를수없는 새로운 흐름임은 누구나 인지하는 시대가 되었다.
개발에서는 그럼 AI를 어떻게 활용을 해야할까? 생각해봤다.
AI를 적극 활용하되, 그 사용의 범위를 잘 정해서 절제하며 사용을 해야할것같다.
특히 요즘 개발자들은,
AI에게 초벌 개발을 맡기고, 그 개발코드를 다듬어서 개발을 하는 방법을 쓰는 개발자들도 많이 있다.
나는 이런 방법을 경계해야한다고 생각한다.
적어도 주니어 단계의 개발자라면 더더욱 경계해야한다고 생각한다.
개발자에게 초기 코딩 단계는 상당히 소중한 작업이고, 시간이다.
초기에 코딩을 한다는것은 단순히 코딩을 한다는것을 넘어서,
해당 기능을 만들기위해 설계와 요건,구조등을 생각하는 시간이 필요하기 때문이다.
이부분들을 고민하고 설계하는 과정을 거쳐서
개발자들은, 특히 주니어 개발자 또는 아직 실력이 모자라다고 느끼는 개발자라면,
논리적으로 생각하고, 단단한 설계를 할수있는 능력이 상승할수있는 단계이고 시간일것이다.
이 소중한 과정을 AI에게 맡긴다는건,
마치 장기게임에서 장기를 두는 플레이어가 아닌, 옆에서 훈수를 두는 사람이 되는것과 같다.
옆에서 훈수를 두면, 플레이어의 잘못한것들이 모두 보이고, 지적이 가능하다.
마치 내가 엄청난 플레이어가 된것같이 착각하기도 한다.
하지만, 실제로 훈수가 아닌 플레이어로 장기게임에 참가하게 되면, 나는 아무것도 못하는 사람이구나’라고 느낄것이다.
내가 개발자로써, 실력이 모라자고, 아직 배움에 대해서 멀었다고 느낀다면,
초기 코딩은 직접 작성하는 방향으로 하는것이 더 좋지 않을까?
누군가, 너 개발자니깐, 이런것좀 만들어줄수있어?라고 했을때,
AI가 없어서 못하겠는데.. 라던가
초기 빈프로젝트부터 내가 설계하고 기능을 만들지 못하면 개발자일까? 코더일까?
내가 만약 이런 상황이라면, 나는 너무 부끄러울것 같다. ㅠㅠ
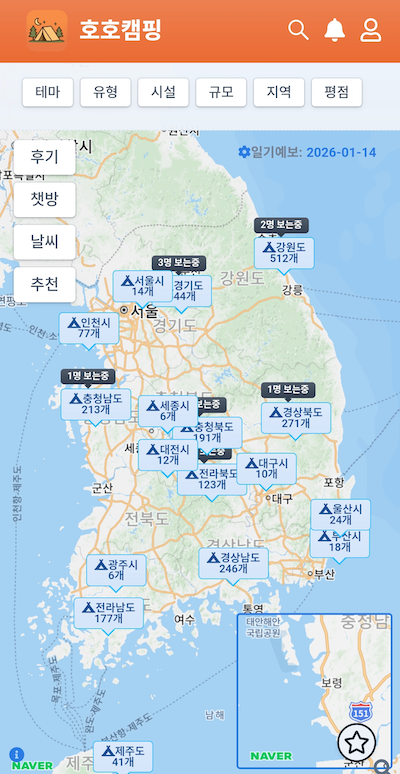
크롤링의 정수를 맛보았다… 각잡고 만들었던 캠핑추천앱..지도를 곁들인..
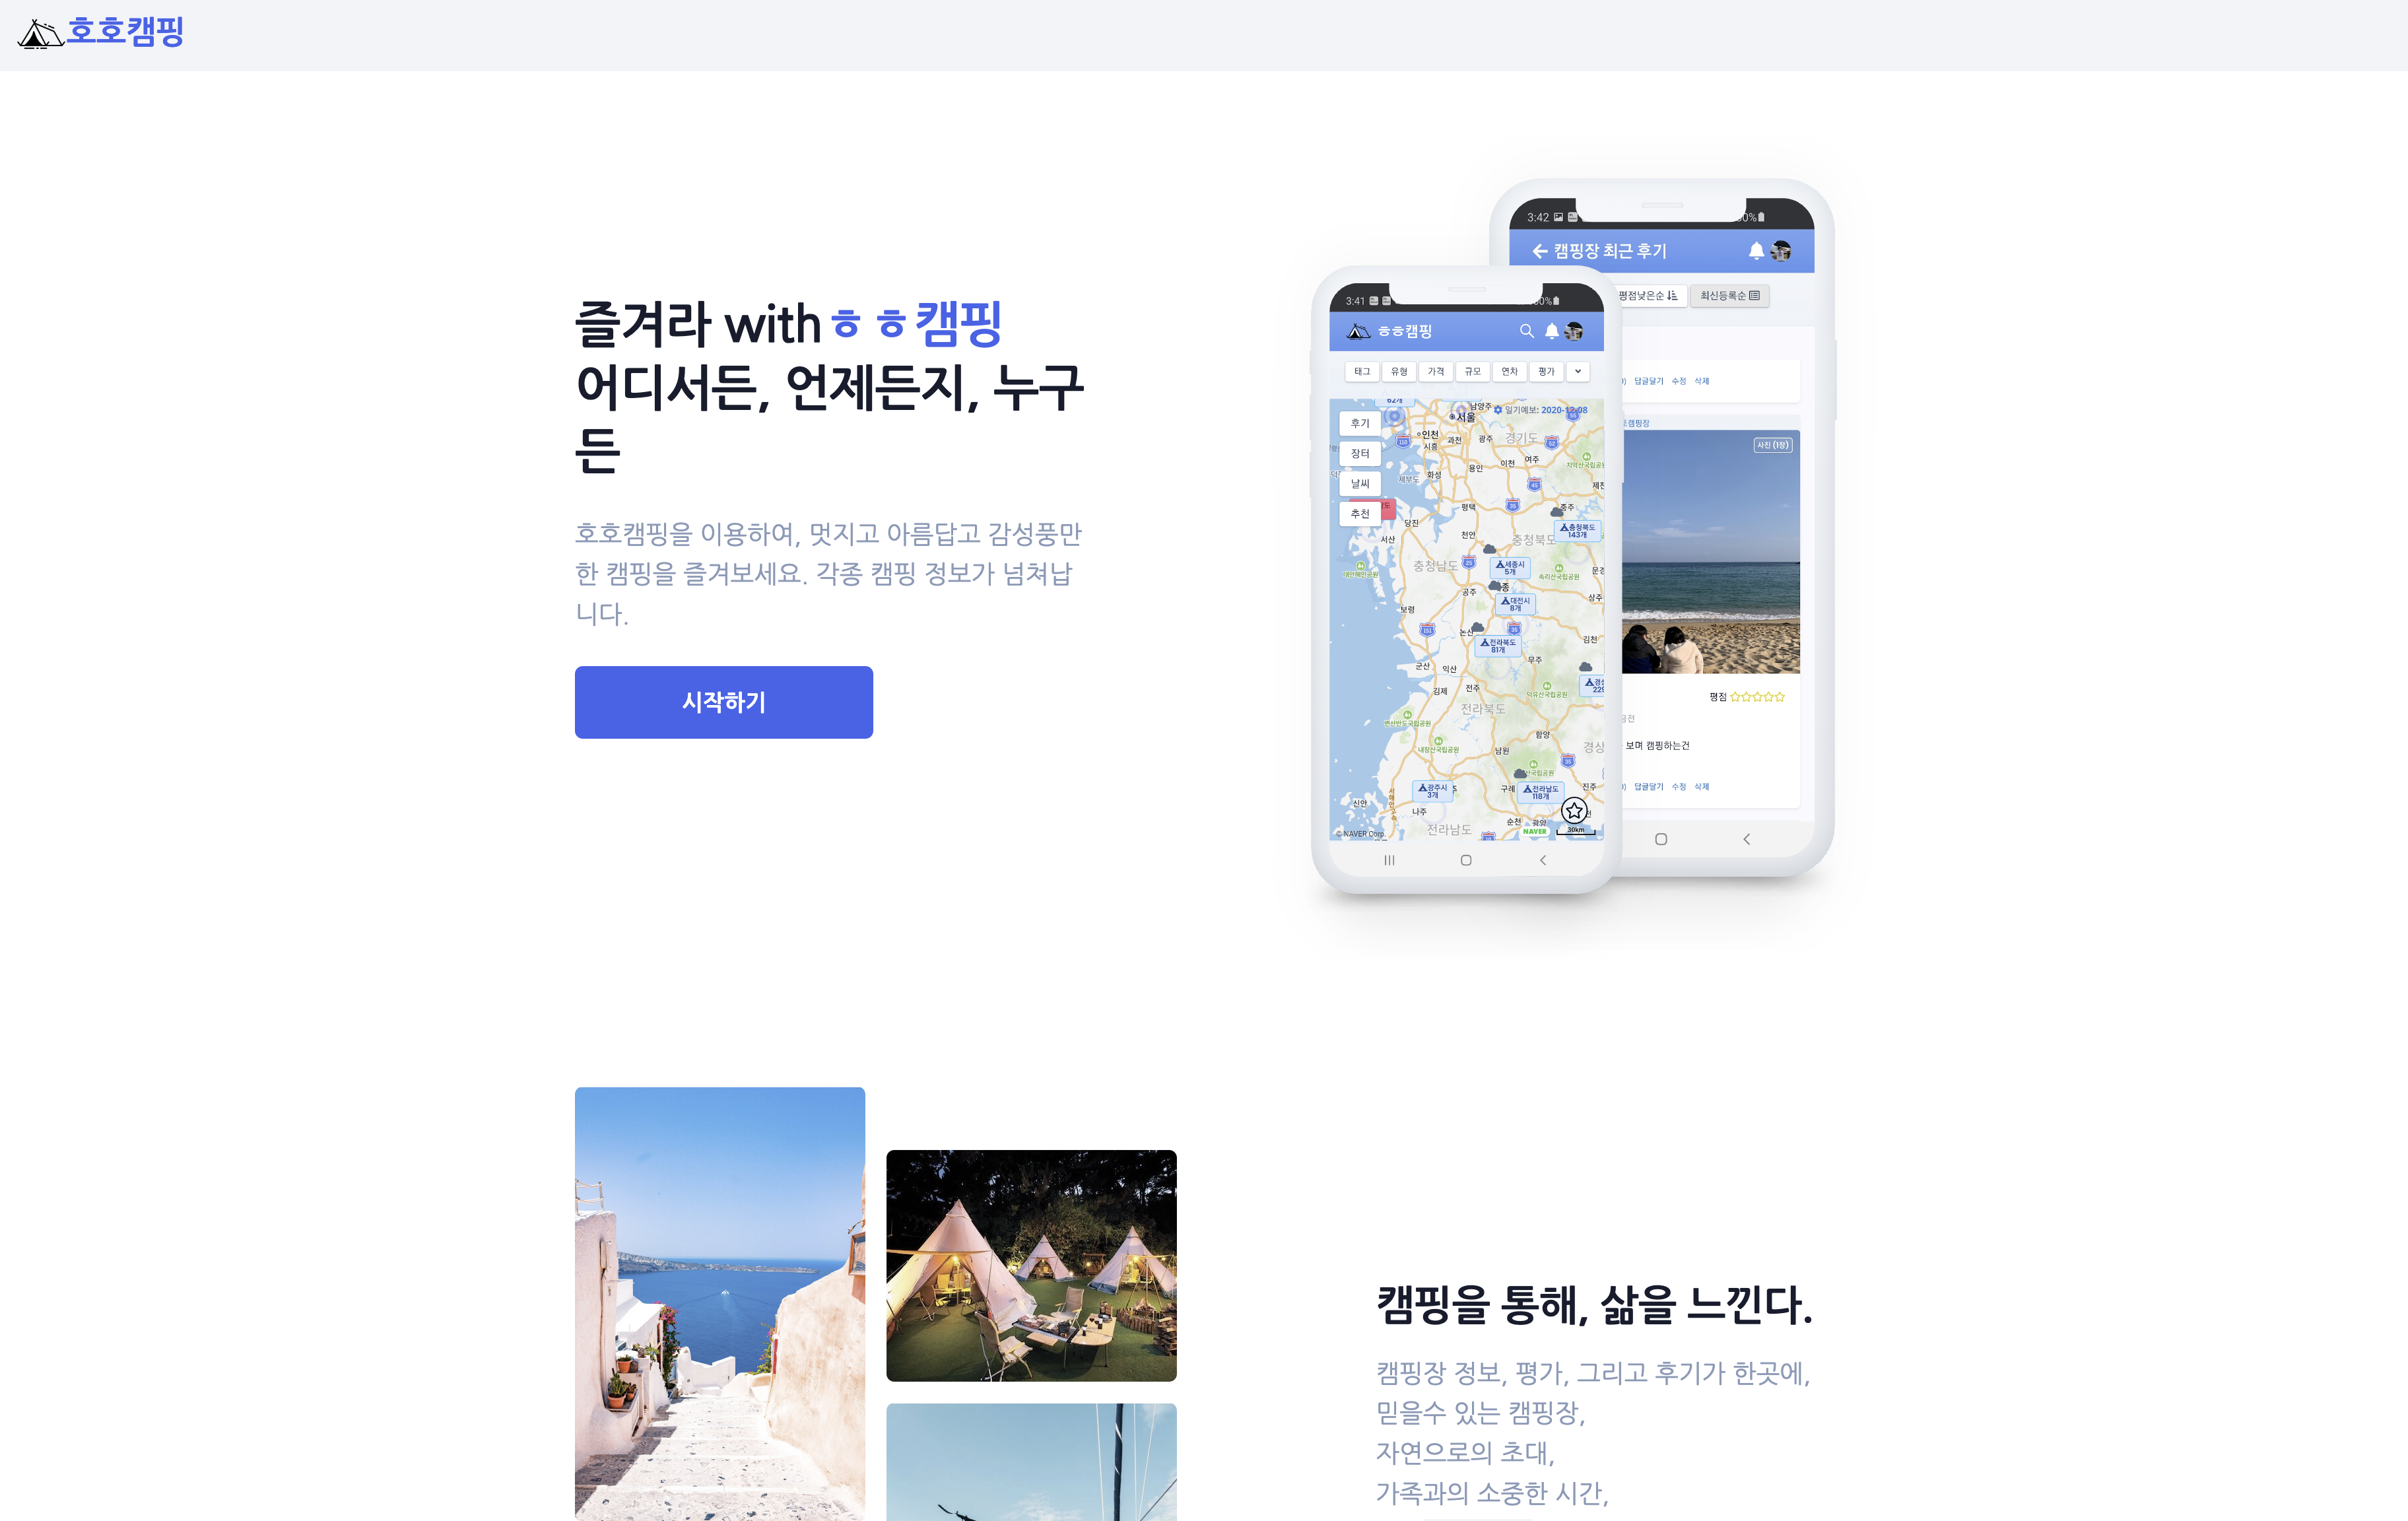
한창 캠핑에 빠져있을때,
항상 좋은 캠핑장을 찾아서, 주말에 떠나는게 가장 큰 낙중에 하나였던때가 있다.
주로 캠핑장을 물색할때는 블로그/카페를 많이 이용했는데,
결국은 추천을 받더라도, 다시 그 캠핑장에 대한 정보를 얻기 위해서 검색의 바다에 허우적거려야 한다는건 정말 피곤한 일이었다.
어느날, 무심코 찾아보니,
공공데이터포털에 전국 캠핑장에 대한 정보가 제공되고 있었고,
여러 캠핑장 메타 사이트가 존재해서,
이런 곳에서 캠핑장에 대한 정보를 모두 크롤링해서 거대한 캠핑정보를 만들어내고,
그 정보를 바탕으로 호갱노노와 같이 사용자가 한눈에 볼수있는, 지도기반으로 정보를 잘 보여주면 편하겠다고 생각이 되어,
호호캠핑이라는 앱을 만들게 되었다.
만들다보니, 욕심이 생겨서, 커뮤니티기능도 넣었고, 평가 요소도 넣고, 조건검색도 넣고, 일기예보도 넣고, 기능들이 점점 많이 들어가게되었다. ㅜ.ㅜ
앱개발에서 특히 신경을 쓴 4가지가 있다.
1) 캠핑장 정보를 여러 소스에서 가지고와서 (크롤링, 공공데이터, 기타등등), 하나의 거대한 캠핑정보 디비로 쌓는 작업이다.
2) 거대한 캠핑정보를 매번 디비에서 가져다 쓰게 만들면, 서버는 많은 무리가 갈것이고, 사용자또한 로딩이 오래걸리기에 사용성이 떨어질것이다.
3) 지도에 이런 거대한 정보를 어떻게 잘 보여줘야할것인가?이다.
4) 지도기반은 정적인 표현기준이라, 동적인 표현을 넣고 싶다.
1번부터 이야기하면, 이경우는 퍼포먼스의 문제로 좁혀졌다.
소스데이터를 수집하는건 그냥 하면 되는 반복작업이라고 볼수있지만,
전국 5천건이 넘는 데이터를 수집하는 프로세스는 멀티스레드로 잘 만들지 않으면, 엄청나게 오래 걸리는,
퍼포먼스가 안나는 작업이 되버린다.
이것은 코루틴, 스레드풀을 사용하여, 비동기로 수집하여 합치고, 디비에 저장하고 하는 방식으로 퍼포먼스를 올리는 방법으로 개발을 하였다.
2) 거대한 이 정보데이터를 앱이 서버로 부터 데이터를 가져오게 만들면, 로딩이 많이 걸렸다. 따라서, 해당 정보데이터를 파일로 미리 만들어두고, 해당 파일을 앱에서는 초기 설치/로딩시에 다운로드하게 만들고, 해당 데이터를 앱로컬내부에서 사용을 하게 만들었다. 웹앱이였기때문에, 네이티브앱에서, 해당 데이터를 Json데이터를 로드해서, webview javascript bridge로 연결하여, webview쪽으로 데이터를 주입하여, 바로 사용가능하게 만들었다.
3) 5천개가 넘는 데이터를 지도에 어떻게 표현하는가?라는 문제는, 지도의 확대률에 따라, Marker의 레벨을 다르게 해서 보여주는 방식을 택했다. 지도가 축소된 상태라면, ‘도’ 기준으로 어그리게이션 하여 마커들을 보여주었고, 지도가 좀더 확대가 되면, ‘시’기준으로, 더 확대가 된다면, ‘군,구’기준으로 마커를 보여주었고, 더 확대가 되면, 그때 마커는 캠핑장 마커들을 해당 지도에 보여주게 만들었다.
사용자는 내가 원하는 지역으로 드레그하고 확대를 하면서 캠핑장의 정보를 바로 얻을수있는 UI를 경험하게 된다.
4) 지도위에 단순 마커로 캠핑장을 표현하는건, 재미가 없다. 너무 정적이라고 해야하나…그래서 지도상에서, 현재 해당 지역, 해당 캠핑장을 같이 보고있는 사용자들의 수를 표시하도록 만들었다. (지금 x명 보는중)
이부분은 웹소켓을 이용해 지도의 같은 좌표, 같은 캠핑장을 보는 경우를 집계하여, 보여주도록 기능을 만들었다.
실시간 이벤트에 SQL을 적용해보자.
소스: https://github.com/dk-stationery/stationery-ink
ETL 빅데이터를 처리하다보면, 정적인 데이터 이외에,
카프카등 큐에 들어오는 실시간성 이벤트를 이용하여, 통계 데이터를 만들어야하는 경우가 생기게 된다.
이경우, 요즘은 스파크같은 마이크로 배치가 지원되는 플랫폼을 사용을 많이 하지만,
내가 stationery-ink를 만들었을때(2010년초?!)는 아직 스파크가 초기버전이였다…
(따끈따끈한 아기 Apache Spark…)
그당시, 주류는 Apache Storm이라는 실시간 처리 플랫폼이 메인 스트림이였다.
이 플랫폼을 사용한다고 해도,
카프카에 담긴 데이터를 sum, avg등 어그리게이션을 하기위해서는 결국, 프로그래밍을 해야했다.
스트림에서 sum, avg등 어그리게이션을 하는것은 정말 까다롭다.
스트림은 지속적으로 흘러가는 이벤트고,
여기서 어느 기준(윈도우 Time, Length, Size등의 개념)으로 어떤 범위까지 어그리게이션을 해야할지를 코드로 구현하기는
엄청 힘든작업이기 때문이다.
이부분은 esper라는 cep플랫폼을 이용하여, 쉽게 할수있기때문에, Apache Storm + Esper조합으로 실시간 어그리게이션을 많이 했다.
여기서 아이디어가 나왔는데,
이런 어그리게이션작업을 코딩으로 구현하지 말고,
자체 SQL쿼리를 이용하여, 자동으로 이벤트를 어그리게이션해주는 플랫폼을 만들수 있지 않을까?? 라는 생각이 들었다.
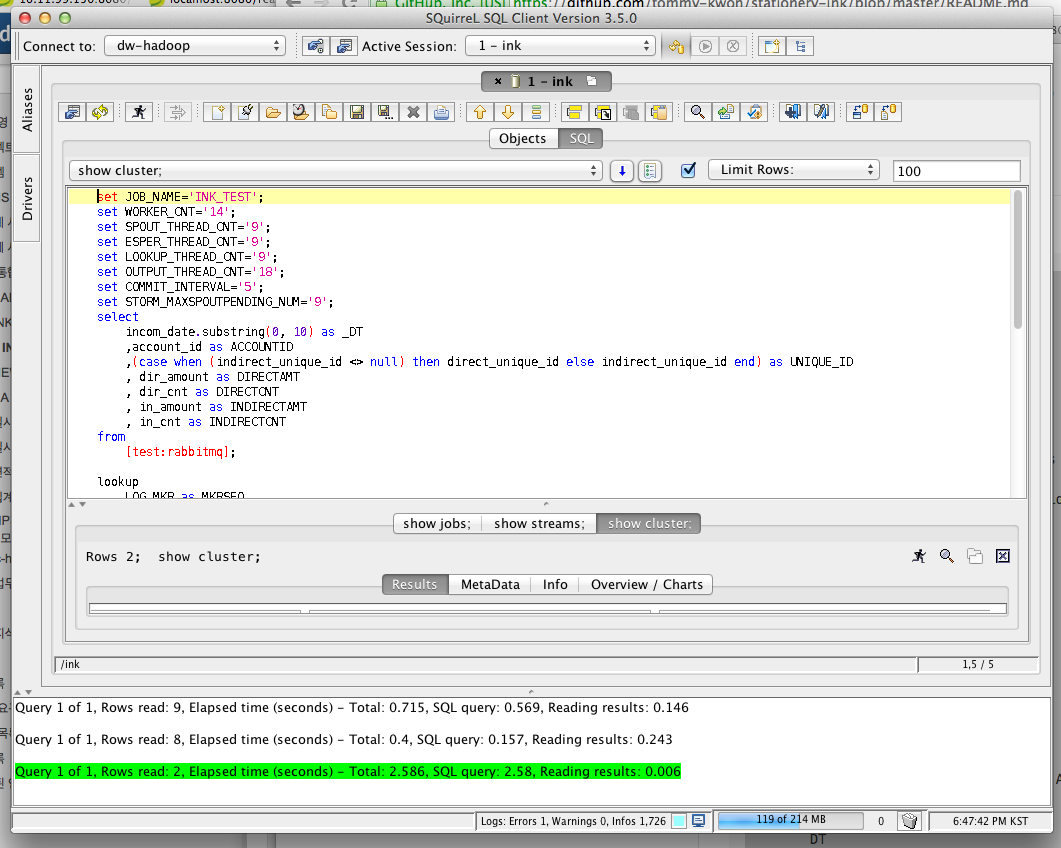
SQL쿼리를 자체적으로 만들기위해 Antlr3를 이용해서 쿼리 visitor 클래스들을 만들어냈다.
해당 쿼리를 통해,
카프카,디비,레디스등에서 오는 스트림데이터를 esper를 통해 어그리게이션하는 과정을 자체 SQL쿼리 베이스로 동작하게 만들었다.
그리고 이런 쿼리는 자체 Jdbc드라이버를 구현하여, 쿼리툴을 이용해 쿼리를 실행/구동할수있게 만들어서 범용성을 높였다.
( 이부분은 정말 될까?라는 의심반으로 했는데, 잘동작하는것을 보고, 흐믓했던 기억이 있다. )
이 플랫폼을 만들고 제일 먼저 한게,
Apache Storm을 만든 개발자,
Nathan Marz에게 “내가 이런것을 만들었는데 어때??” 라고 메일을 보냈다.
하지만, 메일은 읽었지만, 답변은 없더라…. (야속해)
그리고 2년정도 지나고나서, Apache Storm에서는 내가 만든것과 유사한 쿼리 베이스의 어그리게이션 기능이 나왔다.
속으로 (후후후…이녀석…)이라고 생각했다.
그리고 최근에 우연히 본 오픈소스, KsqlDb를 봤는데, 내가 만든 플랫폼과 거의 90% 컨셉이 일치하였다..그때 충격이란..
(2019년에 나왔는데, 나보다 3년이나 늦게 나온건데…)
역시, 개발도 타이밍 같다…
이 플랫폼 만들어서, 사내에서 적용해서 많이 사용했다. 분명 그당시 센세이션한 놈이였다고 분명히 생각하지만,
알아주는 사람은 없긴했다.
하지만 이 플랫폼을 만들면서 배운 것들이 정말 많았다.
Antlr3, Hbase, Storm, Redis, Jdbc Driver, Phinex, Esper에 대해서 많은 배움이 있었기에 후회는 없다.
보람만이 있을뿐!
(아래는 간단한 SQL 소개)
쿼리 중에 가장 중요한게 create source 쿼리다 이건 스트림소스의 접속정보를 등록하는 쿼리이다.
create source kafka meta (
		CATALOG 'KAFKA'
		, URL '127.0.0.1:2181,127.0.0.2:2181,127.0.0.3:2181,127.0.0.4:2181');
이렇게 하면 kafka라는 접속정보를 통해 카프카에 커넥션을 해서 데이터를 받아오게된다.
create stream은 해당 접속 정보를 통해 실제 이벤트 스트림 (테이블)을 만드는 쿼리이다.
create stream testA (_PAYLOAD_ STRING) meta (TOPIC 'testA_topic', TYPE 'topic|queue');실제 쿼리는 아래와 같은 쿼리를 사용가능하다.
select
		DMP_LOG.host
		,DMP_LOG.path
		,DMP_LOG.payload.message
	from
		[testA:kafka] as DMP_LOG
	where
		DMP_LOG.payload.message is not null;
카프카 이벤트에서 payload필드의 message가 not null인것을 select하는 쿼리이다.
set JOB_NAME='INK_TEST';
set WORKER_CNT='14';
set SPOUT_THREAD_CNT='9';
set ESPER_THREAD_CNT='9';
set LOOKUP_THREAD_CNT='9';
set OUTPUT_THREAD_CNT='18';
set COMMIT_INTERVAL='5';
set STORM_MAXSPOUTPENDING_NUM='9';
select
    incom_date.substring(0, 10) as _DT
    ,account_id as ACCOUNTID
    ,(case when (indirect_unique_id <> null) then direct_unique_id else indirect_unique_id end) as UNIQUE_ID
    , dir_amount as DIRECTAMT
    , dir_cnt as DIRECTCNT
    , in_amount as INDIRECTAMT
    , in_cnt as INDIRECTCNT
from
    [test:rabbitmq];

lookup
    LOG_MKR as MKRSEQ
    , LOG_ATP as AREATYPE
from
[test_click:phoenix]
where PAYLOAD_CTSA = ‘[:ACCOUNTID]’ AND PAYLOAD_CTSU = ‘[:UNIQUE_ID]’; upsert into [TEST_REPORT:phoenix]( DT ,MKRSEQ ,AREATYPE ,DIRECTCNT ,DIRECTAMT ,INDIRECTCNT ,INDIRECTAMT ) increase values( [:_DT] ,[:MKRSEQ] ,'[:AREATYPE]’ ,[:DIRECTCNT] ,[:DIRECTAMT] ,[:INDIRECTCNT] ,[:INDIRECTAMT] );
이벤트를 조회해서, 이벤트를 DB에 저장하는 쿼리도 가능하다.