[작성자:] kun7788

  • [개발생각] 리더의 역할이 구성원에 대한 기대와 어떤 관계가 있을까?

    요즘 가장 많이 드는 생각이 있다. 리더의 역할이 구성원에 대한 기대와 어떤 관계가 있을까?

    리더는 기본적으로 구성원을 잘 이끌어야한다고 누구나 생각한다.

    이건 누구나 알고있는 만고의 진리같은것이라고 생각된다.

    하지만, 실제로 리더의 생활(?)을 경험을 해보면, 여기서 많은 괴리감이 생김을 알수있다.

    바로, 리더가 어미새, 코치, 선생님이 되어야하는가? 라는 생각이다.

    구성원들의 모든 부분에 대해 파악을 하고, 누구와 사이가 좋은지, 좋지않은지를 알고, 어떤 업무를 싫어하는지 알아야하고, 왜 기분이 좋지않는지를 파악해야하는것… 이런것을 리더의 역할이라고 생각을 하는 구성원들이 많다는 것이다.

    이런 부분을 해결해주지 않는 리더는 리더의 역할을 잘하지 못한다고 판단을 실제로 많이한다.

    (참 무섭지… )

    물론, 일정부분은 구성원간의 관계에 대해서 파악을 하고, 인지하고 있어야하는 부분이 있는것은 사실이지만…

    리더도 사람이다.

    4-5명정도가 넘어가는 팀의 리더라면 (나는 20명 팀원 리더도 경험해봤다…ㅜㅜ)

    물리적으로나 논리적으로나 무리가 있다.

    따라서, 리더의 역할을 구성원을 보살피고, 살갑게 어루만지는 역할이라고 생각하는 부분에 대한 인지의 반전이 필요하다.

    (물론, 위의 역할이 아예 없어야한다는 이야기가 아니고, 주 역할을 어떤 역할로 봐야하는것인가에 대한 생각이다.)

    리더는 어미새가 아닌, 구성원들이 하나의 목표, 하나의 방향으로 가기위한 조타수의 역할이 주 역할이라고 생각한다.

    이 조타수의 역할을 잘한 리더라면, 다른 부분에서 조금 부족하더라도, 좋은 리더라고 판단할수있다고 나는 생각한다.

    (모든것을 잘할수있는 사람이 어디 있을까?)

    여기서, 조타수의 역할이란,

    리더는 구성원들이 잘못된 방향으로 가지않게 목표와 지향점을 제시해주는게 중요하다고 생각한다.

    그러기 위해서,  팀,프로젝트내에 룰을 만들거나, 설계에 관여하거나, 목표를 설계하는 역할이라고 생각하고,

    여기서 잘되지않는 부분에 대해서,

    구성원들에게 ‘우리가 잘못하고 있어! 그러니 정신차리고 하자!’라는 리마인드를 해주는 역할이라고 생각을 한다.

    여기서, 리마인드의 방법은 여러가지가 있을것이다. 직설적으로 ‘너! 잘못하고 있으니, 잘해!’라고 할수도있고, 은유적으로 돌려서 말할수도있을것이다. 하지만 여기서 일정선을 넘지않는 기준에서는 직설적이거나 은유적이거나는 리더의 성향이지, 어떤 방법이 더 좋다고 판단할수없다고 생각한다. 

    리더의 이런 리마인드에 대해서, 결국은 구성원들이 어떻게 피드백을 각자가 가져가는가에 달려있다.

    차갑게 이야기하면, 방향과 목표를 제시해주고 리마인드된 이후부터는,

    그 방향을 따르고 안따르고는 구성원들의 책임이고, 의무라는 것이다.

    그러면,

    구성원들의 피드백이 개선되지 않는다면, 리더는 어떻게 해결을 해야할까?

    아마 두가지겠지…

    화를 내고 야단을 치거나, 참고 지속적으로 리마인드 시키는법..

    화를 내는 것은 간단한 방법일것이고, 때로는 효과적일수도, 때로는 부작용이 클수도있는 방법이다.

    참고 지속적으로 리마인드 시키는 방법은, 지루하고 효과가 미비할수도, 아주 가끔은 때로는 잘 먹힐수도있는 방법이다. 

    가장 좋은 방법을 선택하라면, 리더는 지속적으로 리마인드 시키는 방법이겠다…

    누가봐도, 가장 합리적이고 이성적인 방법이라고 생각할테니, 당연한 소리다.

    여기서… 큰 현실적 장벽에 부딪친다.

    지속적인 리마인드 방법은 사실, 효과가 거의없다…

    정말 효과가 미비하다…

    (왜냐고? 개선과 노력을 요구하는 리더의 리마인드를 심각하고, 중요하고, 뼈져리게 받아들이는 구성원들은 거의 보지 못했기 때문이다..)

    질책을 받는 그 부분에 대해서 자존심이 상하고, 기분이 나쁠뿐이고, 나의 잘못을 성찰하기란 쉽지않다.

    (질책 좋아하는 사람이 몇이나 있을까)

    지속적인 리마인드 방법이 효과를 보기위해서는 구성원들의 마인드셋이 우선은 변화해야한다는 전제조건이 필요하기 때문이다.

    아무리 좋은 말이라도, 받아들이는 사람이 받아들이지 않으면 소용없는것과 같다.

    아무리 좋은 음식이라도, 먹는 사람이 먹지않으면 소용없는것과 같다.

    결국, 리더의 역할도 중요하지만,

    구성원들의 마인드셋이 어느것보다도 정말 중요하다.

    나의 문제점에 대해, 깊게 이해하고, 문제에 대한 심각성을 인지하고,

    좀더 앞으로 나아가고자 하는 의지가 있는 구성원의 마인드셋이 중요하다.

    이 부분이 선행되지 않으면, 효과가 미비하다.

    그럼 이 마인셋은 어떻게 탑재하게 만들수있을까?

    사실 엄청 힘들다. 

    불가능에 가깝다.

    시간으로 굳혀지고, 습관과 문화로 굳어진 마인드셋은 상당히 고치기 어렵다 (습관을 한순간에 고칠수있을까?)

    그래서 필수적으로 뒤따라야 하는 것이, 전폭적인 지지와 권한 그리고 지원이 필요하다.

    (2002년 히딩크에게 축구협회가 전폭적인 지지와 지원을 해주었고, 이런 지원과 권한을 가진 히딩크는 국가대표팀의 여러 관습을 없앴고, 불만, 불필요하고 불합리한 썩은 마인드셋을 변화시켰다.)

    전폭적인 지원,권한이 없었다면, 아무리 훌륭한 히딩크라 하더라도, 쉽지 않았을것이다.

    그만큼 구성원의 마인드셋을 무너트리고 새로 쌓아올리기는 쉽지 않다.

    전폭적인 지지와 권한, 지원을 하지않고, 단지 리더의 책임감으로, 리더의 역할이다 라는 논리로 구성원들의 마인드셋까지 변화시키길 요구하는것은 너무나 가혹한 이야기이고, 무책임한 이야기다.

    결국은, 팀, 회사, 문화가 새롭게 탈바꿈하기 위해서는 리더들의 노력, 구성원들의 마인드셋, 회사의 전폭적인 지지와 지원 

    이것들이 삼위일체가 되어야 가능한것이라는것을 우리는 꼭 알아야 한다.
  • [개발생각] ActiveMq에서 Topic을 Queue방식으로 컨슘하기

    이번주에 삽질을 한부분을 글로 남겨둔다.ㅠ 셋팅문제긴했지만, ActiveMq는 사실 십몇년전에 레포트만들때 잠깐 사용한게 전부,

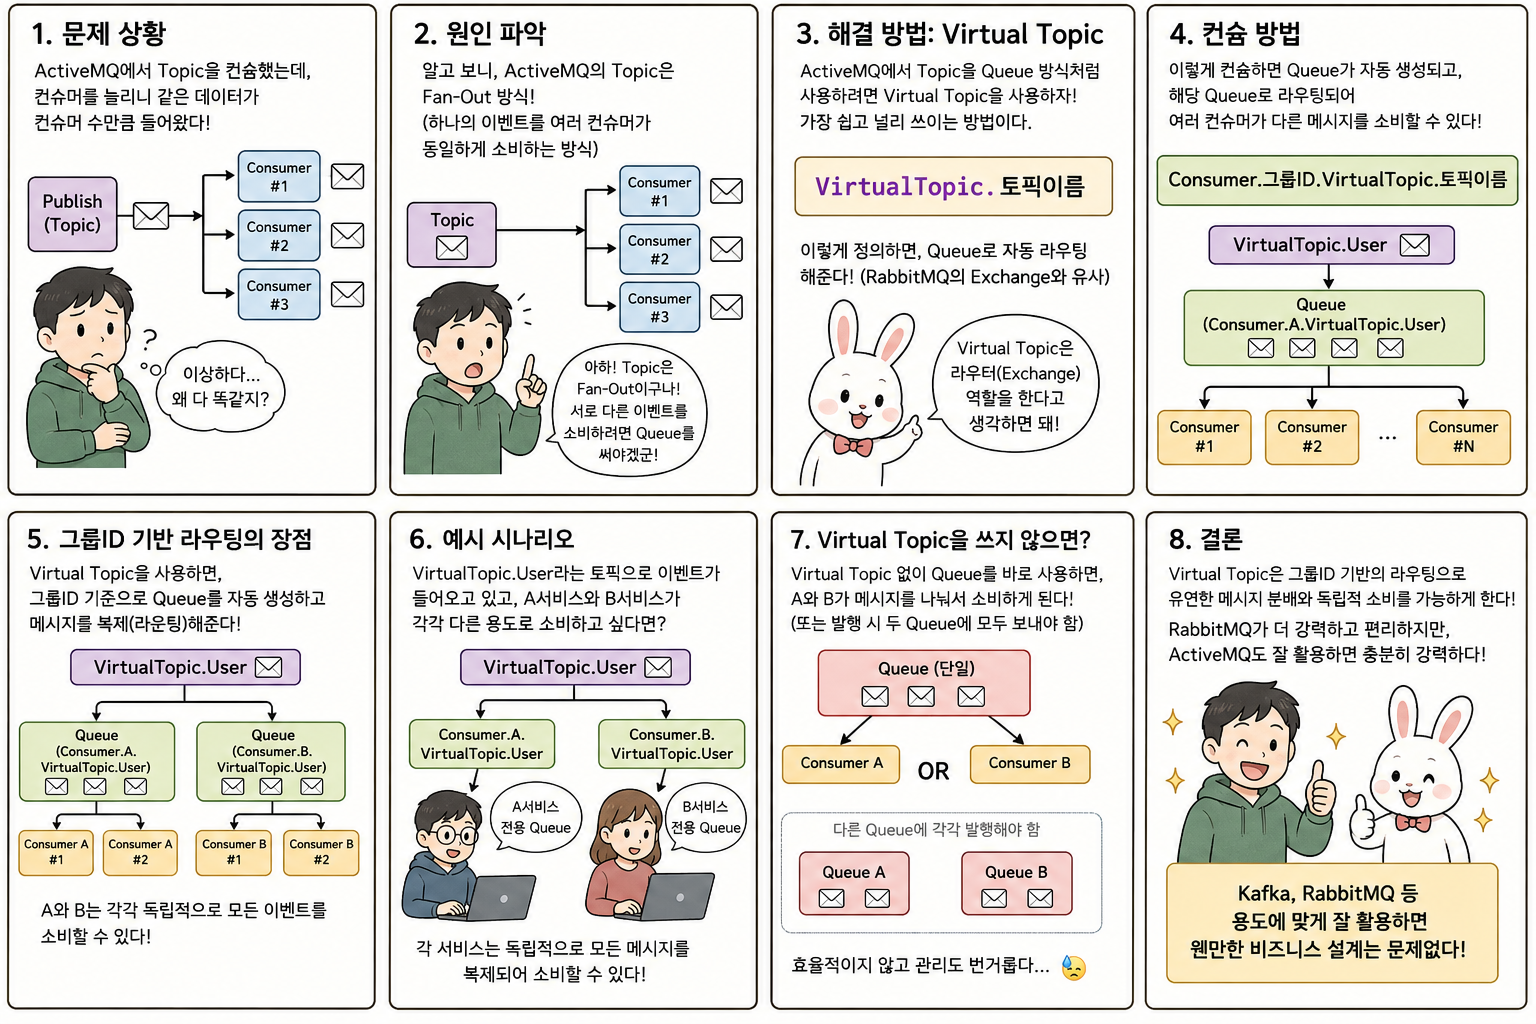
    ActiveMq에 Topic을 컨슘을 해야했다. 컨슘을 했고, 컨슈머를 이제 늘려서 성능을 높이려고 늘려서 테스트를 하는데,

    같은 데이터가 컨슈머 갯수만큼 들어왔다. 이상하다라고 생각이 들어서, 확인해보니,

    ActiveMq에서의 Topic은 Fan-Out방식으로 동작을 한다는것을 알았다.

    (하나의 이벤트를 여러 컨슈머가 동일하고 소비하는 방식)

    즉, 같은 이벤트를 동일하게 컨슘하는 방식이고, 여러 컨슈머가 서로 다른 이벤트를 소비하려면,

    Queue방식으로 컨슘을 해야한다는것을 알았다.

    참… 토픽, 큐 정의 명확히 통일좀 시켜주면 안될까..ㅋㅋ

    카프카, 레빗엠큐, 액티브엠큐에서 의미하는것이 조금씩 틀려서 헷갈릴때가 많다..

    암튼, ActiveMq에서 Topic을 Queue방식으로 컨슘을 하기위해서는 몇가지 방법이 있다.

    그중에서 가장 쉽고 많이 쓰는 방법인 Virtual Topic에 대해서 이야기를 하려고 한다.

    Virtual Topic는 RabbitMq에서 라우터(Exchange) 역할을 하는 기능이라고 생각하면 될듯하다.

    사용법은 아래와 같다.

    VirtualTopic.토픽이름

    이렇게 정의해서 사용하면 되는데, VirtualTopic.프리픽스가 붙게되면,

    해당 토픽은 Queue로 자동으로 라우팅이 되게 해준다.

    해당 토픽을 Queue방식으로 컨슘하려면 아래와 같다.

    Consumer.그룹ID.VirtualTopic.토픽이름

    이렇게 컨슘을 하면, 

    “VirtualTopic.토픽이름”에 발행된 이벤트가 “Consumer.그룹ID.VirtualTopic.토픽이름”이름으로 큐가 생성되고,

    해당 큐로 이벤트가 라우팅 되고, 해당 큐를 컨슘하게 되면, 이제는 여러 컨슈머가 다른 이벤트를 컨슘할수있게 된다.

    여기서 한가지 궁금증이 있을것이다.

    아니 그러면 그냥 처음부터 큐만들어서 해당 큐로 컨슘하면 되지 왜, 불편하게 VirtualTopic을 만들고,

    Consumer 머시기머시기하는 규칙으로 컨슘을 하나? 라는 생각을 할수있는데, 여기서 가장 큰 장점이 있다.

    VirtualTopic기능을 사용하면, 이벤트를 그룹ID기준 Queue로 라우팅을 해준다는 것이다.

    예를 들어보면)

    VirtualTopic.User라는 토픽을 만들었고, 해당 토픽으로 이벤트가 들어오고 있는 상황인 경우,

    해당 토픽을 A라는 서비스와 B라는 서비스가 각각 컨슘을 해서 별도의 기능에 사용하고 싶다고 했을대,

    “Consumer.A.VirtualTopic.User”

    “Consumer.B.VirtualTopic.User”

    라고 A서비스와 B서비스가 각각 Queue를 컨슘하게되면,

    해당 이벤트는A,B라른 그룹아이디기준으로 별도의 Queue되여 메세지가 복제된 상태를 유지해 주기때문에,

    이후부터는 별도로 이벤트를 컨슘할수있게된다.

    여기서 VirtualTopic를 사용하지않고, Queue를 바로 사용하는 경우에는,

    즉, Queue로 바로 컨슘을 하게된다면, 라우팅을 할수없게되기에, A,B가 이벤트를 나눠서 컨슘하게 된다…

    아니면, 발행시에 Queue를 두군데에 모두 동일하게 발행을 하는 방식을 쓰던지 해야한다 (구리지..)

    결국은 VirtualTopic에서 groupId를 설정할수있기에, 분산 컨슘이 되는것이라고 이해해도 되겠다.

    개인적으로는 ActiveMq보다는 RabbitMQ가 더 나은것 같다.

    (RabbitMQ가 훨씬 기능도 많고, 좋다!!!)

    Kafka, RabbitMq 정도를 용도에 맞게 잘사용하면 웬만한 비즈니스적 설계는 커버가 된다..

    좋아요공감공유하기통계

  • [개발생각] Bloomfilter에서 삭제가 가능하다면?

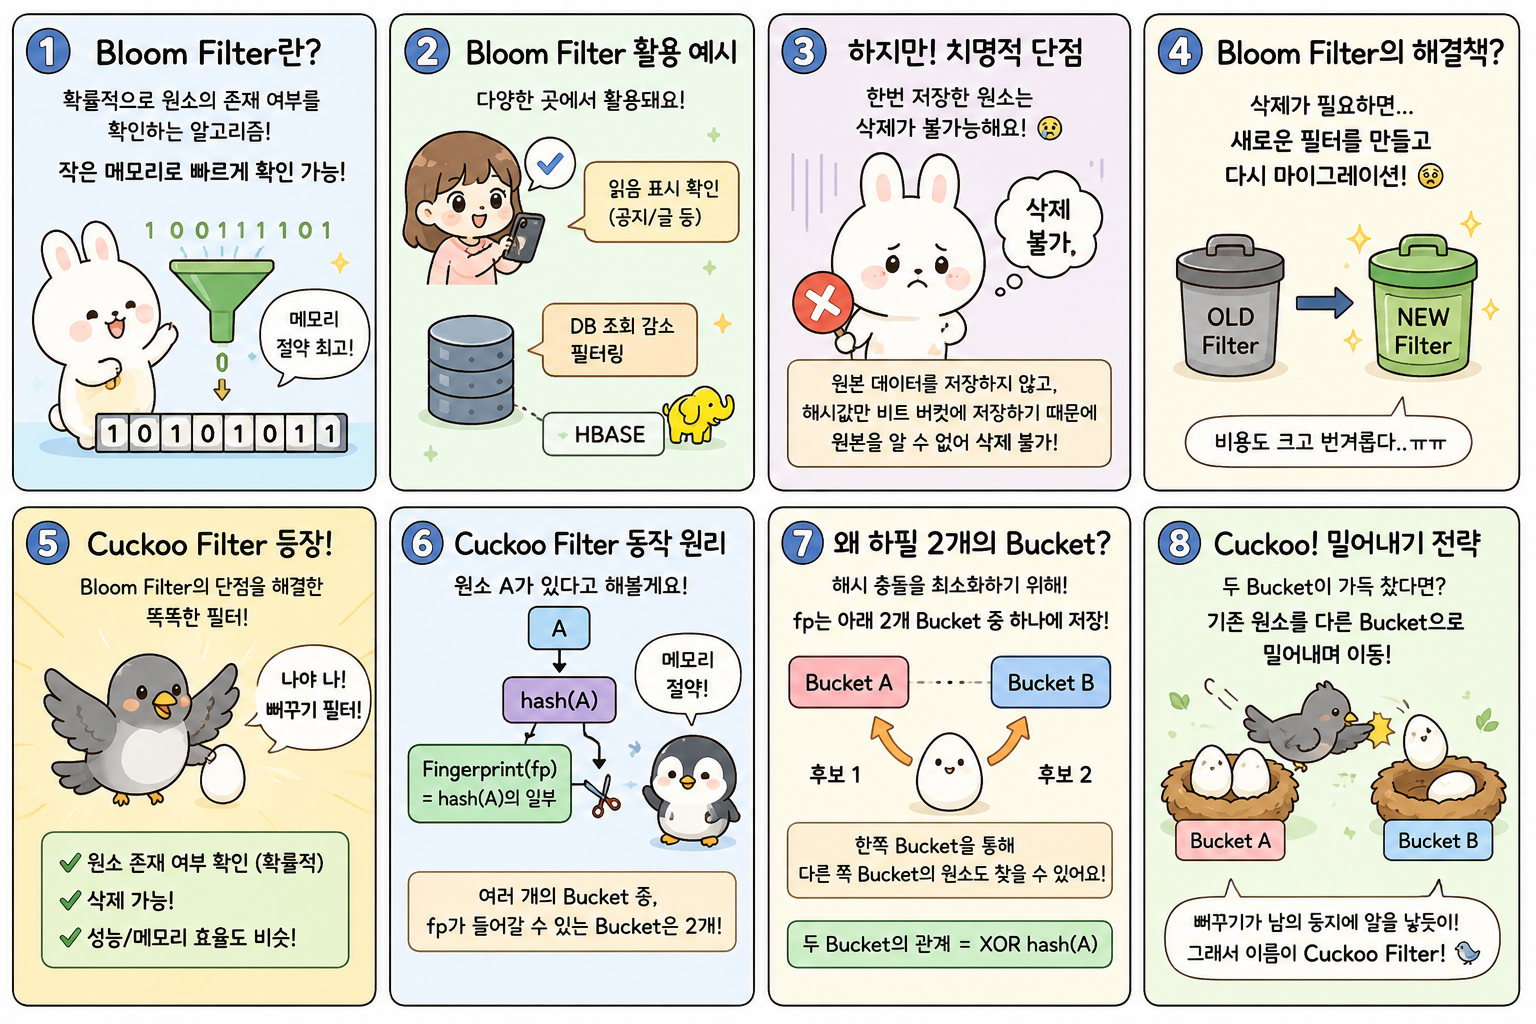
    BloomFilter는 확률적으로 원소가 존재하는지를 확인하는 확률기반 알고리즘이다. 작은 메모리로 원소 존재여부를 확인할수있다.

    BloomFilter는 많은곳에서 활용이 가능하다.

    공지/글등의 읽음표시여부에 사용할수도 있고 (내가 적용했지 후후..),

    디비의 조회를 줄이기위한 필터링으로도 사용가능하다 (HBASE가 정말 BloomFilter를 적극적으로 사용했지..)

    하지만 이런 좋은 기능이지만, 단점이 하나있다.

    바로!!! 한번 저장한 원소(값)은 삭제를 할수없다는 것이다.

    이게 당연한것이,

    BloomFilter는 해시값을 비트버킷에 저장을 하는 방식이기에,  원본 데이터를 저장하지 않는다.

    따라서 원본 데이터를 알수없기에 삭제도 할수없는 것이다.

    따라서, 삭제가 필요하다면,

    BloomFilter 버킷을 새롭게 만들고 다시 마이그레이션하는 방법을 써야한다.

    이런 단점을 해결한 알고리즘이 하나 있다.

    Cuckoo Filter

    일명 뻐꾸기 필터이다.

    CuckooFilter는 BloomFilter와 동일하게 확률적기반으로 원소 존재여부를 확인해준다.

    더불어, 원소(값)의 Fingerprint 즉 해시일부값을 저장하고 있기때문에 원본 데이터를 알수가 있고

    (물론, 해시 일부이기에 중복 조회될수있다), 해당 원본 데이터를 삭제할수가 있다.

    엄청난 장점!!

    더불어 성능이나 메모리도 크게 BloomFilter와 차이가 없다.

    간단하게 동작하는 방식은 아래와 같다.

    원소(값)이 A라고 하면, 
    
    fp = hash(A) substring 0, x //해시값의 일부만 핑커프린트를 사용 (메모리 효율)


    여러개의 bucket들이 존재한다. (List<Bucket>)
    
    그중에 fp가 들어갈수있는 bucket는 2개이다.
    
    bucketA
    
    bucketB
    
    둘중에 하나의 bucket에 fp를 저장함.

    fp를 bucketA 또는 bucketB에서 찾는다! 

    삭제는 fp가 있는 bucket에서 해당 fp를 삭제처리해준다.

    여기서 정말 중요한부분이 있다.

    왜 fp를 저장할 bucket를 굳이 2개의 bucket후보를 선정하고 그중에 하나에 넣는가?

    해시 충돌을 최대한 없애기 위함이다.

    원소값의 해시의 일부만을 저장하기에 하나의 버킷에 많은 원소의 핑거프린트값을 저장하게 되면,

    해시 충돌이 급속도로 늘어나게 된다.

    따라서 버킷을 2개로 분산하여 해시 충돌을 없애는 방법을 사용한것이다. (미쳤다…만든사람)

    그리고 버킷후보 2개중에 한쪽에 데이터가 저장되기에,

    bucketA를 통해 bucketB의 원소를 찾을수있어야한다.

    또한 bucketB를 통해 bucketA의 원소를 찾을수있어야한다.

    해당 후보 bucket들의 관계는 XOR hash(원소) 로 만들어 한쪽의 버킷으로 다른쪽 버킷을 찾을수 있게 한다.

    즉, 원소 존재여부를 확인할때, 2개의 버킷을 조회할때 효율이 늘어나게 된다.

    그리고 해당 버킷의 사이즈가 모두 차면, 기존에 있던 원소를 다른 여유있는 버킷으로 이동을 시키게한다 (캐시만료 정책 LRU 느낌??!)

    여기서 Cuckoo라고 이름을 지은 이유가 나온다.

    (뻐꾸기가 남의 둥지에 알을 낳을때, 기존 알을 밖으로 밀어내서 없애버린다는 의미,

    버킷이 가득찼을때, 기존 원소값을 다른 버킷으로 이동 시킨다는 의미)

    프로젝트에서 EV자동차연동을 한 유저가 홈에 접근했는지 여부를 현재는 BloomFilter를 사용하고 있는데,

    현재는 일정시간간격으로 BloomFilter를 매번 새로 만들게 구현을 했다 (삭제가 안되니 ㅠ)

    이걸 CuckooFilter를 사용하면, 매번 필터를 만들 필요없이 사용이 가능할것 같다.

    좀더 고민을 해보고, 적용을 해볼지 결정을 해봐야겠다!

    (UserId + 필터가 존재해야하는 시간간격값 => Key로 하면, 딱인듯!!!)

  • [개발생각] jpa에서 조인 Entity를 사용하는 신박한 방법

    JPA에서 엔티티에 관계설정을 하지 않고, 조인을 유연하게 사용하는 방법은 뭐가있을까?

    정답은 아니지만, 오늘 좀 신박한 방법을 하나 생각해내서, 공유를 해본다.

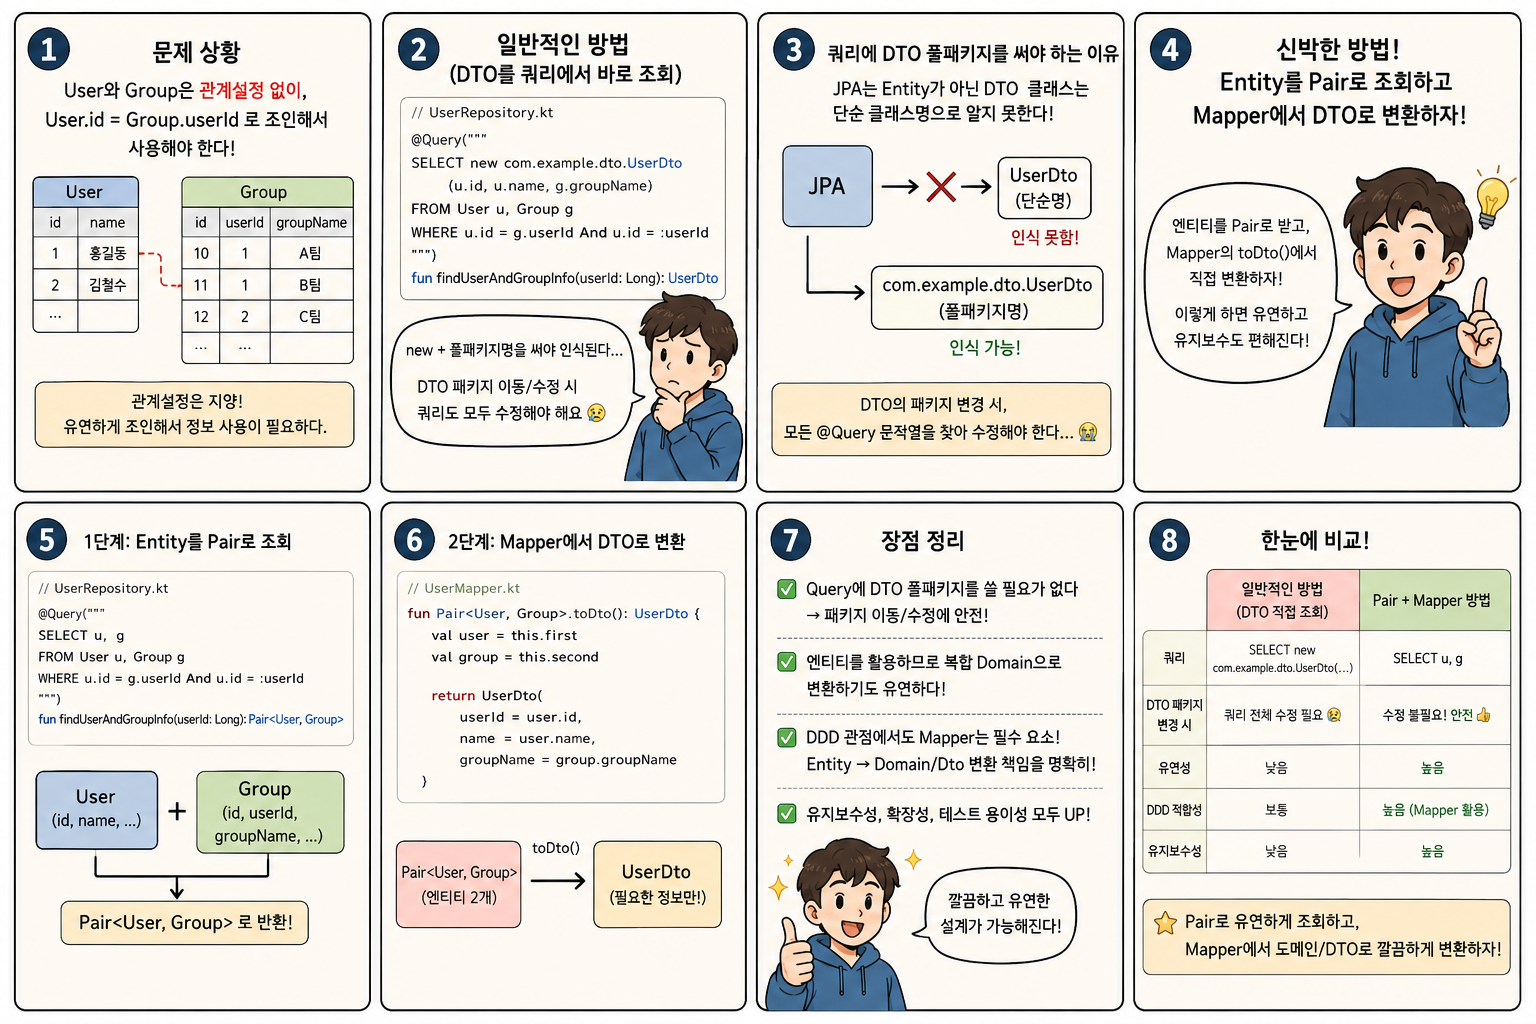
    User, Group 엔티티가 존재한다고 해보자!

    User의 id와 Group의 userId로 조인해서, User정보와 Group정보를 합쳐서 사용해야한다.

    (Jpa에서 관계설정 방법은 지양하는 전제조건이다)

    이럴때, 아래와 같이도 할수있겠다고 생각했다.

    (이런생각 한사람이 많을까? ㅋ.. 좀 정상아닌것 같기도 하지만.. 구현해보니 나름 장점이 많다)

    //UserRepository.kt
    interface UserRepository : JpaRepository<User, Long> {
    
       @Query("
            SELECT u, g FROM User u, Group g 
            WHERE u.id = g.userId And u.id = :userId      
       ")
       findUserAndGroupInfo(userId:Long) : Pair<User, Group>
    }
    
    //UserMapper.kt
    Pair<User, Group>.toDto() : UserDto {
    
      val user = this.first
      val group = this.second
      
      return UserDto(
             userId = user.id,
             name = user.name,
             groupName = group.groupName
       )
    }

    일반적으로는, @Query에서 리턴값을 UserDto로 바로 받는 방법을 많이 쓴다. 아래와 같은 방법 말이다.

    //UserRepository.kt
    interface UserRepository : JpaRepository<User, Long> {
    
       @Query("
            SELECT UserDto(u.id, u.name, g.groupName) 
            FROM User u, Group g 
            WHERE u.id = g.userId And u.id = :userId      
       ")
       findUserAndGroupInfo(userId:Long) : UserDto
    }

    그런데 여기서 위와 같은 Query구문은 사용할수가 없다.

    JPA에서 UserDto를 바로 찾지를 못하기 때문이다.

    (Entity package가 아니기에, jpa에서 UserDto클래스를 알수가 없어서, 단순하게 클래스명만으로는 사용/주입 할수없다)

    //UserRepository.kt
    interface UserRepository : JpaRepository<User, Long> {
    
       @Query("
            SELECT new com.example.dto.UserDto(u.id, u.name, g.groupName) 
            FROM User u, Group g 
            WHERE u.id = g.userId And u.id = :userId      
       ")
       findUserAndGroupInfo(userId:Long) : UserDto
    }

    이렇게 new com.example.dto.UserDto(xxxxx) 풀패키지명을 Query문에 써줘야한다..

    그런데 이게 문제가 뭐냐면,

    만약 UserDto의 패키지를 이동하거나 삭제하거나, 수정했을때,

    저 쿼리구문을 모두 찾아서 풀패키지명을 수정해줘야한다는 것이다…

    별것 아닌것 같지만,

    유지보수에 너무나도 단점으로 다가온다.

    이런 이유로 처음 방법을 생각해봤다.

    Entity를 그냥 Pair클래스로 결과로 받고,

    해당 2개의 Entity 결과(User, Group)를 toDto 변환하는 확장함수를 만들어서 toDto함수로 변환할때,

    직접 맵핑을 해서 UserDto를 만드는 방법이다.

    엔티티를 toDomain()으로 변환하는 Mapper는 DDD에서는 필수로 있어야하는 요소이기도 해서,

    Mapper에서 Dto클래스에 담아주게 관리를 한다면, 관리측면이나, DDD측면에서도 훨씬 장점이 많다.

    바로 User, Group엔티티를 이용한 복합 Domain Class로 변환도 가능해서 훨씬 유연해진다.

    이 방법은 앞으로 자주 사용하자!!!! (아니면 위와같은경우는 과감하게 QueryDsl을 사용하자!)

    단점이 없다!!! 완.벽.해!!!!

  • [개발생각] API 패키지를 어떻게 관리하면 될까?

    클린코드에서든 레거시에서든, 어떻게 해야할까?라는 생각이 잠깐씩 들때가 있다. 바로 API패키지를 어떻게 가져가야하지? 생각이다.

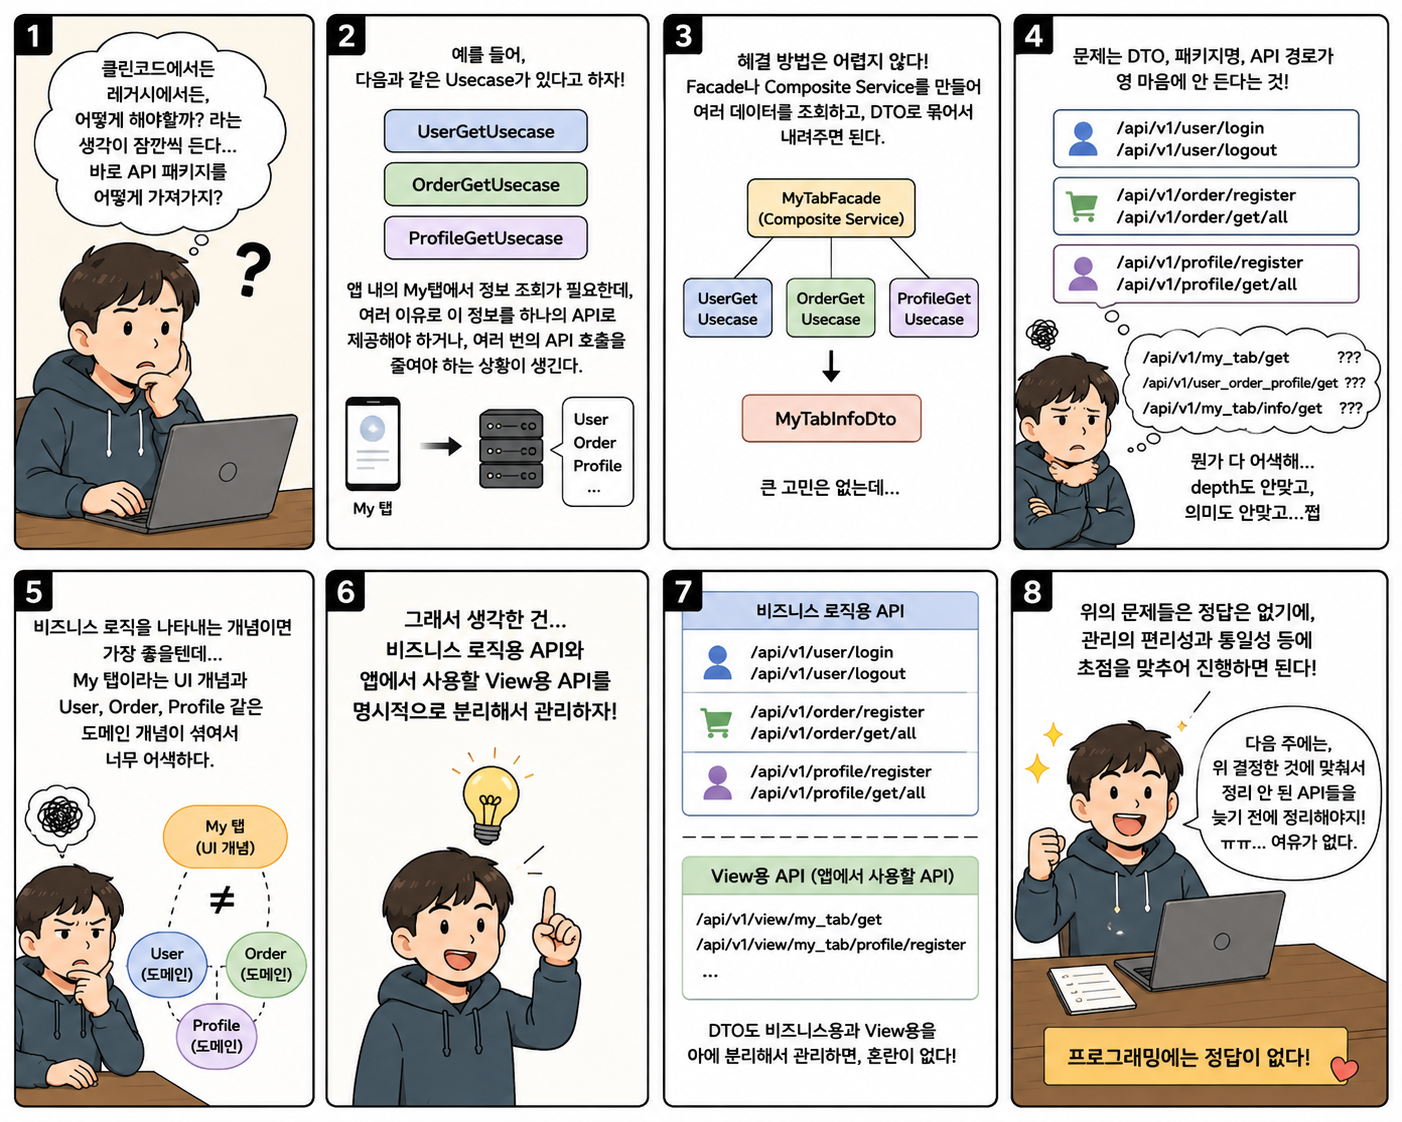
    UserGetUsecase, OrderGetUsecase, ProfileGetUsecase가 있다고 하자!

    앱내의 My탭에서 정보조회를 해야하는데, 여러 이유때문에 User, Order, Profile정보를 하나의 API로 제공을 해야한다.

    또는 앱에서의 여러번의 API호출을 줄이기위해, API를 묶어서 한번에 조회하는 API를 제공해야한다면..

    이런경우, Facade를 만들거나, 컴포지트 Service를 만들어서 여러개를 조회해서, DTO로 내려주면 되기에, 큰 고민은 없는뎅…

    고민은 DTO와 Package명, api경로가 영 너무 맘에 안들게 된다.

    예를 들면)

    /api/v1/user/login

    /api/v1/user/logout

    /api/v1/order/register

    /api/v1/order/get/all

    /api/v1/profile/register

    /api/v1/profile/get/all

    등으로 usecase단위로 api를 만드는데, 갑자기 위와 같은 상황이 되면,  API의 경로를 어떻게 해야할지가 순간적으로 고민이된다.

    /api/v1/my_tab/get ===> ???

    /api/v1/user_order_profile/get ===> ???

    /api/v1/my_tab/info/get ===> ???

    뭔가 다 어색해…

    user, order, profile와 my_tab가 depth도 안맞고, 의미도 안맞고…쩝

    비즈니스 로직을 나타내는 개념이면 가장 좋을턴데…

    my_tab에서 조회해야하는 API를 어떤이름으로 api uri를 따야하는걸까??

    bff서버가 있으면, 아예 깔끔하게 분리가 되니, 좋을테지만,

    그래서 생각한건..

    비즈니스로직용 API와 앱에서 사용할 view용 api의 경로를 명시적으로 분리해서 관리하는게 낫겠다고 결정했다.

    비즈니스로직용 API 

    /api/v1/user/login

    /api/v1/user/logout

    /api/v1/order/register

    /api/v1/order/get/all

    /api/v1/profile/register

    /api/v1/profile/get/all

    view용 API (앱에서 메뉴별 API, 성능상의 이유로 여러 비즈니스 usecase의 데이터를 한번에 내려줘야하는 API)

    /api/v1/view/my_tab/get

    /api/v1/view/my_tab/profile/register

    이런식으로 /view/ 나 차라리 /app/ 의 path를 명시적으로 추가하고, 분리해서 관리하고,

    DTO도 비즈니스로직용과 view용 DTO를 아예 분리해서 관리하면, 혼란이 없을듯하다.

    위의 문제들은 여태 고민을 한적이 없었는데, 이상하게 이번 프로젝트는 고민포인트로 다가왔다..

    뭔가, 성능을 좋게해야하고, API의 호출을 줄여야하고, 효율적으로 동작해야한다는 생각때문인것 같기도 하고…

    뭐, 정답은 없기에, 관리의 편리성과 통일성등에 좀더 초점을 맞추어 진행하면 될것같다!!

    프로그래밍에는 정답이 없다!

    다음주에는, 위 결정한것에 맞춰서, 정리안된 API들을 늦기전에 정리를 해야지 ㅠㅠ…

    여유가 없다.

  • [개발생각] SSS 암호화 대해서

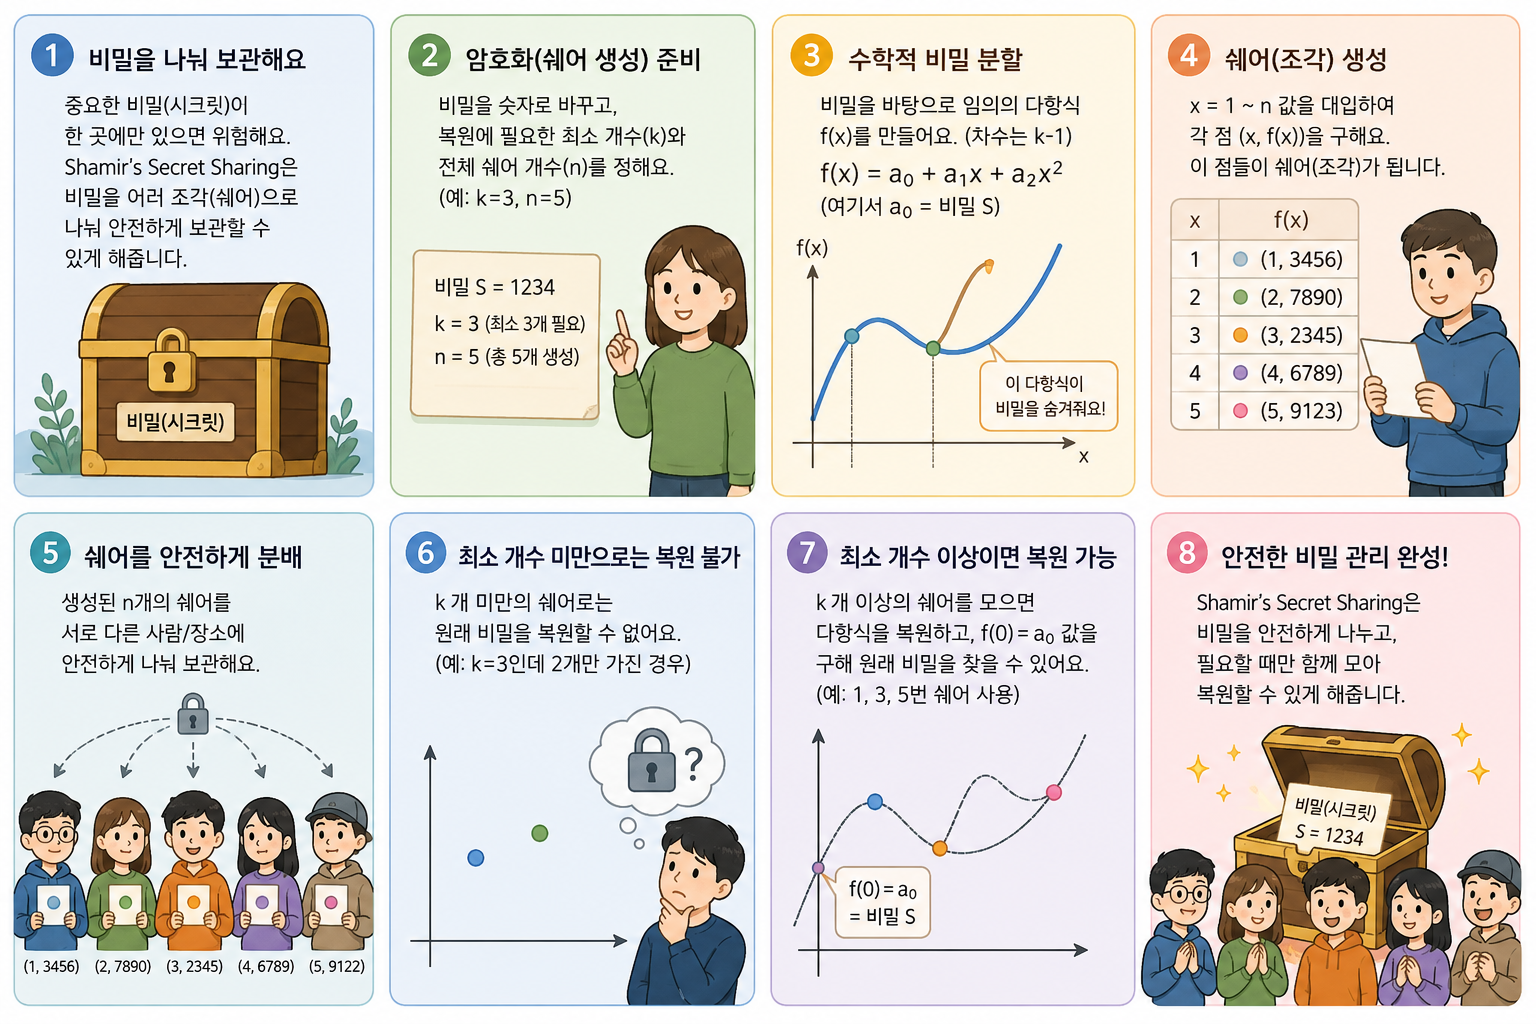
    Sharmir’s Secret Sharing 암호화 방법 있는데, 일명 트리플 S…

    요즘 알고리즘 공부를 하고있어서, 생각난 암호화기술이긴한데, 생각보다 재미도 있고,

    예전직장에서 이 암화화방법을 이용해서 아이디어를 냈다가, 까인적도 있어서..기억에 많이 남는다.

    (그런데, 왜 까였을까? ㅋ 아직도 모르겠다..)

    예를 들면,

    “Hello Word”라는 문장을 암호화한다고 할때

    복호화 키를 몇개를 만들것이고, 해당 복호화키중에 몇개의 키가 있으면 복호화를 할수있는지를 미리 정해서 암호화를 할수있다.

    예를 들면)

    평문 : 123 있다고 하자.

    함수:

    f(x)=123 + 2x + x²

    암호화후 결과 값 :

    x=1 → 126
    x=2 → 131
    x=3 → 138

    사람들에게:

    (1,126)
    (2,131)
    (3,138)

    위 3개 정보를 각자 나눠준다.

    3개의 정보가 하나로 합쳐져야 실제로, 123이라는 평문으로 복호화가 가능하다.

    다항식의 해를 이용하여, 다항식을 유도하고, 해당 유도한 다항식에서 f(0)이 되는 값을 찾는 식이라고 생각하면 된다.

    이 sss암호화를 이용해서 아이디어를 냈던건,

    요즘 보이스 피싱등으로 나이든 어르신들이 많은 피해를 보는것을 알았기에,

    이체가 발생할때, 아들, 딸들에서 이중으로 이체 확인을 받은후, 이체가 되는 안심이체 시스템 아이디어를 낸적이 있다.

    이름하여, [보이스피싱을 막는 안심이체 시스템] !!!

    이체를 하려면, 아들,딸등 미리 대상을 설정해둔 이체확인자에게 푸시알림이 가고,

    해당 금액의 이체를 컨펌해주면, 실제 이체가 되는 아이디어였는데,

    이때 이체컨펌을 위한 정보를 디비등에 평문으로 가지고 있지않고,

    sss암호화를 통해, 2명, 3명 또는 n명에게 암호키와 암호문조각을 전달하고, 해당 n명의 암호키와 암호문으로 복화화가 하여,

    이체 컨펌을 하도록 하여, 분산 처리와 암호화를 동시에 만족하게 하는 아이디어였다.

    그런데, 이 아이디어는 받아들여지지는 않았다.

    (왜 인지는 사실 아직도 모르겠다.. 아마 생소한 암호화방법을 가지고 와서, 거부감이 있었던걸까?..)

    이런것을 디비로 하려면, 상당히 스키마가 복잡해진다.

    예를들면)

    sender, amount, recevier, confirmUser1, confirmUser2, confirmUser3, confirm1_done, confirm2_done, confirm3_done

    이런식의 컬럼이 있어야할것이다…

    sender : 보낸사람
    
    amount : 이체 금액
    
    recevier : 받는 사람
    
    confirmUser1 : 이체 컨펌자1
    
    confirmUser2 : 이체 컨펌자2
    
    confirmUser3: 이체 컨펌자3
    
    confirm1_done : 이체 컨펌자1의 이체 컨펌 여부
    
    confirm2_done : 이체 컨펌자2의 이체 컨펌 여부
    
    confirm3_done : 이체 컨펌자3의 이체 컨펌 여부

    이런식의 데이터를 테이블에 가지고 있어야한다.

    하지만, sss암호화를 사용하면,

    sender, amount, recevier, key1, key2, key3, done 으로 테이블을 구성할수있다.

    sender : 보낸사람
    
    amount : 이체 금액
    
    recevier : 받는 사람
    
    key1 : sss를 통한 암호조각1
    
    key2 : sss를 통한 암호조각2
    
    key3 : sss를 통한 암호조각3
    
    done : 컨펌완료여부

    즉, confirmUser1, confirmUser2, confirmUser3등의 유저정보를 테이블에 넣지않고,

    해당 암호키를 가지고 유저가 key를 제출하면, key들을 가지고 복호화를 하여 컨펌해주는 방식으로 동작할수있다.

    이렇게 key만을 가지고 컨펌여부를 체크하게하면, 컨펌User의 데이터와 독립적으로 테이블을 유지할수있고,

    디펜던시가 사라져 훨씬 유연하게 테이블을 관리하고 사용할수있다.

    단순 복호키만으로 컨펌User를 특정하지않고, 컨펌여부를 처리할수있기때문이다.

    (zk 영지식 증명 비슷하기도!)

    기회가 되면, 이런 비슷한 곳 (여러사람이 컨펌하여 무엇인가를 하는 행위)에 적용을 해봐야겠다!

  • [개발생각] PostgreSQL의 하이퍼테이블 사용

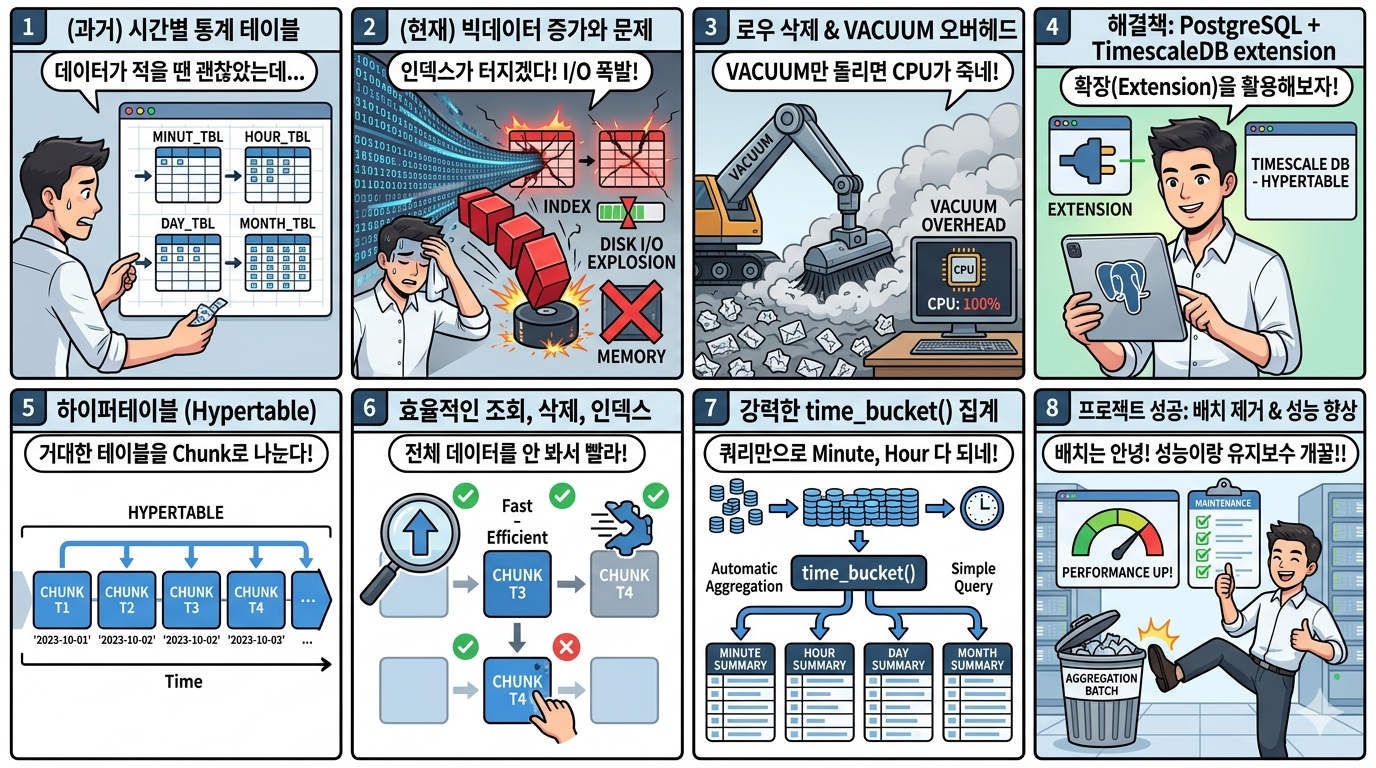
    기존에 통계 데이터를 minute, hour, day, month등의 테이블로 나누고, 테이블에 날짜키로 Insert를 했었다…

    일반적인 데이터의 크기라면 상관이 없지만, 데이터가 빅데이터 수준으로 늘어나게 되면,

    여러가지 문제가 생긴다.

    인덱스가 커지게 되고, 해당 인덱스을 메모리상에 올리지 못하게 될때는, 디스크 IO가 폭발적으로 발생할수있다.

    로우 삭제가 있는 테이블이라면, 추후에 VACUUM 오버헤드가 엄청나게 들어나게 된다.

    (VACUUM 작업은 그냥 디스크 정리 같은거라고 생각하면 쉽다.)

    삭제된 로우를 실제적으로 정리하면서, 인덱스도 지우고, 디스크도 정리하고 하는 작업인데,

    테이블의 데이터가 빅데이터라면, cpu 오버헤드가 상당해진다.

    이런 단점을 극복하기위해서 PostgreSQL은 extension으로 TimescaleDB기능인 하이퍼테이블을 지원한다.

    해당 하이퍼테이블은 시계열 테이블이다.

    하이퍼테이블은 일반 테이블처럼 하나의 물리 테이블이 아닌,

    특정 시간대의 chunk로 데이터를 작게 나눠서 저장하기에, 데이터 조회/삭제/인덱스생성등의 작업등의 여러 오버헤드를 줄일수있다.

    삭제나, 조회시 해당 chunk단위로만 동작하기에, 전체 데이터를 대상으로 동작하지 않기에,

    훨씬 적은 데이터 대상으로 빠르게 처리가 가능하다.

    또한 time_bucket 기능으로 특정 시간동안의 데이터를 어그리게이션(집계)하여 테이블에 반영할수도있어서,

    기존처럼 minute, hour, day, month별 테이블에 각각 집계하여 insert하거나 집계 배치등을 통하지 않아도,

    단순 쿼리를 통해, minute, hour,day, month등의 기준으로 자동으로 집계를 하도록 설정을 할수있다.

    (이게 정말 개꿀이다!! 심지어 성능도 더 좋다니!!!)

    이번 프로젝트에서도, 기존 통계테이블을 없애고, 하이퍼테이블과 타임버킷을 통해,

    통계데이터를 PostgreSQL 쿼리만으로 집계하도록 바꿨다.

    기존 집계하는 배치를 없앴고, PostgreSQL기능으로 집계가 자동적으로 되기에,

    성능과 유지보수에도 더 좋아지게 되었다.

    프로젝트 시작 초기에, ClickHouse디비를 눈여겨 봤었다…

    상당히 빠른 시계열 컬럼디비로 파악을 했는데… 아쉽게도 이번 프로젝트에는 도입을 하지않았다.

    도입을 하지않은 가장큰이유는,

    너무나 생소하고 처음인 디비였기에, 성능, 기능이 아무리 뛰어나다고 하더라도, 

    운영/노하우가 쌓이이지 않은 솔류션을 중요한 프로젝트에 바로 도입하기는 부담이 되었기 때문이다.

    좀더 시간이 있었더라면, 여러 실험이나 테스트를 했겠지만, 

    실험이나 테스트에서도 나오지 않는 여러 트러블등은 역시나… 운영하면서 100% 발생한다.

    이때, 빠르게 대응하지 못한다면, 큰 부담으로 다가온다…

    (이번에는 아쉽게 패쓰!!!!)

    다음에 ClickHouse를 도입할수있으면 한번 해보고 싶긴하다… 빅데이터에서의 컬럼형 디비는 엄청나게 빠르니까!!!

    (컬럼디비의 원조는 hbase가 아닐까?!! ㅋㅋ hbase의 column family개념이 컬럼 개념이였던듯!)

  • [아이디어] 16년된 게임개발 아이디어…

    30살? 회사에 출근하면서 생각한 게임 아이디어였는데… 문득 생각이 났다.. 16년이 넘어서, 생각이 나다니..후 🙂

    30살때, 회사가 멀어서 지하철을,  1시간씩 전철을 타고 다녔다.

    출근중에 음악도 듣고, 영화도 보고 했는데,

    결국은 눈을 감고, 이런저런 몽상을 하다가, 잠이 드는 경우도 많았다.

    이때 공상속에서 생각한 게임 아이디어였는데,

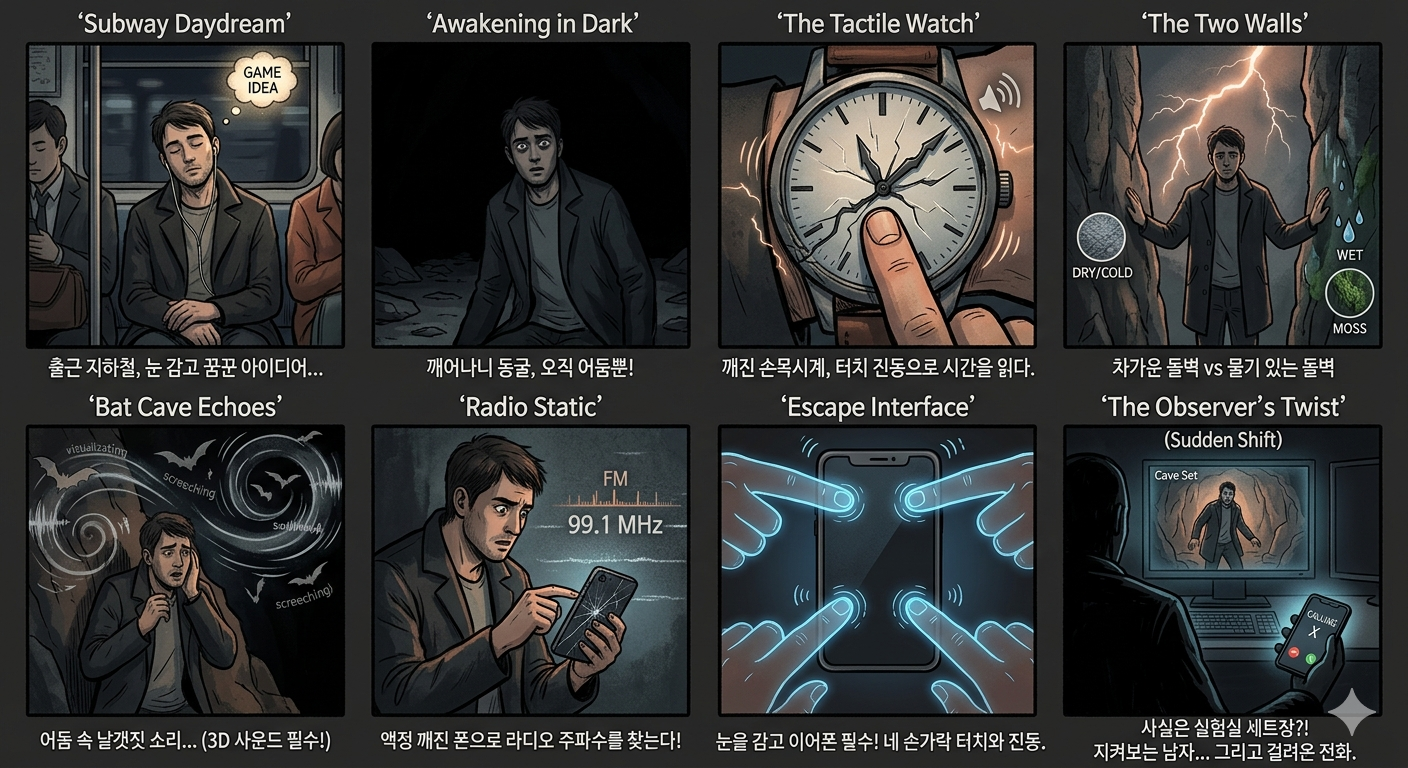
    아예 그래픽을 배제한 사운드, 진동으로만 동작하는 게임을 만들어보면 어떨까?라는 것이였다.

    (음악듣는거 말고 눈감고 지하철에서 할것없나? 하다가 생각함 ㅋㅋ)

    장르 :

    – 미스테리 동굴 탈출

    시나리오 :

    – 출근하던 X가 갑자기 정신을 잃었고, 일어나보니, 동굴안이였다.

    동굴은 빛이 없는 암흑이였고, 손끝에서 느껴지는 터치와 귀로들리는 사운드만으로 동굴을 빠져나가야만 한다.

    다행히 손목시계의 유리가 깨져서, 시,분침을 조심히 만지면, 시간은 알수있었다.

    (앱화면을 터치하면, 시,분침이 있는 부분에서 진동이 발생하게 개발함 – 진동하는 시,분침의 위치로 시간 알수있음)

    지금은 새벽 5시로 추측된다.

    우선 동굴벽을 만져본다.

    동굴벽 한쪽은 차가운 돌로 되있고, 말라있고, 다른 한쪽은 물기가 있는 돌로 되있는듯하다.

    가끔 박쥐인지 뭔지가 동굴을 날아다니는 날개소리가 들린다.. (3d 돌비사운드 기능 필수!!)

    다행히 액정이 깨진 핸드폰을 더듬더듬 실행시켜, 라디오 주파수를 FM으로 맞출수있었던것은 불행중 다행이다…

    주파수가 맞아들어가는 소리를 보고, 밖이라는걸 알수있을듯하다….

    나는 과연 무사히 동굴을 빠져나갈수있을까?

    반전:

    – 사실은 동굴이 아닌, 실험실 케이스에 만들어진 세트에 X는 서있다.

    그 X를 몰래 지켜보고있는 한사람이 있다.

    절대 이 사람은 X에게 이 동굴(세트)에서 빠져나가는 희열과 기쁨을 줄 사람은 아닌걸로 보인다.

    X와 이사람은 과연 무슨 관계일까?

    마지막에 이사람에게서 전화가 걸려오고 비밀이 밝혀진다…

    (비밀은 생각 안했었다…쩝;; 그냥 떡밥만 ㅋㅋ)

    인터페이스 :

    – 눈을 감고, 이어폰 착용 필수이고, 이어폰을 통해, 여러 사운드를 통해, 동굴에서 빠져나갈수있다.

    이어폰착용과 손가락 4개를 앱의 특정위치의 액정에 밀착시키고, 진행을 하게 된다.

    진동과 사운드를 통해, 그리고 터치를 통해 게임을 진행하는 방식이다.

    오감중에 가장 공포감을 느끼게 하는게, 눈이 보이지 않는데, 소리가 들리는 경우가 아닐까? 라는 생각에서 출발했다.

    가장 안도감을 느끼게 하는 시각을 배제하고, 사운드와 진동을 통해, 공포감을 극대화시키는 게임을 생각했었다.

    시간을 내서, 조만간 게임을 만들어보자!!

    AI로 사운드를 쉽게 만들수있으니, 개발은 수월할것같다.

  • [개발생각] 애자일방법론에 대해서..

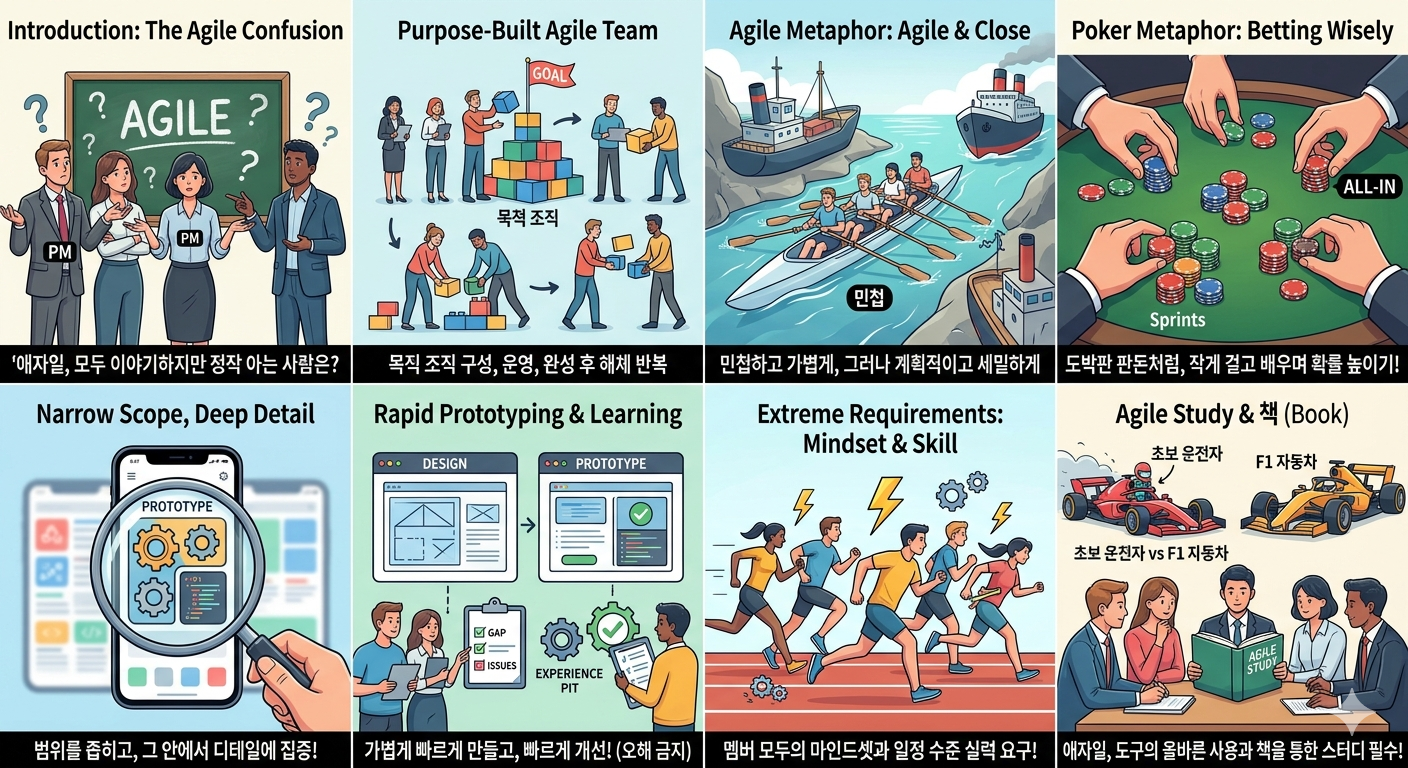
    애자일을 모든 사람들은 이야기하지만, 정작 애자일이 무엇인지를 정확히 알고있는 사람은 많지않다…아니..없는것같기도..

    IT개발에서 가장 많이 하는 방식은 프로젝트팀을 구성하고,

    해당 프로젝트팀에 여러 파트 (기획, 디자이너, 프론트, 서버개발등등) 인원들이 멤버가 되어,

    어떤 목표를 가지고 서비스를 만드는 방식을 많이 사용한다.

    이렇게 목적 조직을 만들고, 운영하고, 서비스가 완성되면, 다시 해체하는 과정을 반복한다.

    여기서, 이런 조직을 원활하게 운영하기 위한 방법으로 애자일 방식 활용을 많이 한다. 특히 IT조직에서는…

    애자일의 뜻은 “긴밀하고, 민첩한”의 뜻이다.

    민첩하게 움직이려면, 수행해야하는것이 가벼워야하고, 긴밀하게 움직이려면, 수행해야하는것이 계획적이고 세밀해야한다.

    민첩과 긴밀함은 사실 배타적인 의미가 될수있다.

    민첩해야하는데, 긴밀해야한다는 것…

    민첩하면서, 긴밀하려면, 우리는 부정확한 미래에 대해서, 모든 노력을 한번에 쏟아붓거나, 너무 많은 리소스를 투자해서는 안된다. 

    이런 의미로 나온게 애자일 방법론이라고 생각한다.

    마치 도박판에서 판돈을 걸때, 모든 돈을 다 걸지 말고,

    작게 걸고, 작게 잃고,를 반복하며, 해당판의 패턴을 파악하고, 흐름을 익히는 경험을 얻어,

    점점 이길 확률을 높여가는 방법!! 이라고  할까???

    그럼 여기서 말하는 작게 걸고, 작게 잃는다는 의미는 뭐라고 판단해야할까?

    작게 걸었으니, 잃어도 된다고 생각할수도있잖아!

    아니…나는 그렇게 생각하면 안되다고 생각한다.

    작게 걸었다고, 잃어도 되는 것이라고 생각한다면, 잃는것에서 얻을것은 없다.

    작게 걸었어도, 그 작게 건부분에 대해서는 최대한의 노력을 해야한다.

    최대한의 노력이란, 깊게 생각하고, 디테일하게 판단하고 계획하는 것이다.

    큰 범위에서 디테일하게 생각하는것은 많은 시간과 리소스가 들기에, 작게 그 범위를 제한하고, 그안에서 디테일하게 생각하는것으로 이해해야한다.

    가장 중요한 부분은 “가볍고 빠르게 만들고, 빠르게 개선한다”를 절대 오해해서는 안되는 것이다.

    가볍고 빠르게 만들기 위해서, 디테일을 포기하자는 것이 아닌, 가볍고 빠르게 만들기 위해서, 범위(커버리지)를 좁히고, 해당 범위내에서 많은 고민을 통해 프로토타입을 빠르게 만들고, 실제 구현된 부분을 확인하여, 설계단에서 고민한 부분과 현실적으로 구현된 기능에서의 갭이나 이슈가 있는지를 판단해야 한다는것이다. 

    이렇게 빠르게 구현을 해본 경험으로, 다른 삽질을 하지 않을수있기에, 시간적으로나 리소스적으로나 큰 세이브가 될수있기 때문인다.

    다시 말하지만, 가볍고 빠르게 만들자는 의미가, 디테일을 가볍게 하자는것이 아님을 다시 한번 말해둔다.

    범위를 좁히고, 그 안에서의 디테일을 빠르게 잘 파악하고(국소적으로) 만드는 방법임을 다시 한번 강조한다.

    그리고… 가장 중요한 한가지!!

    애자일 방법은 절대 누구나 할수있는 쉬운 방법론이 안다…

    기획자, 개발자, 디자이너를 프로젝트팀으로 만들고, 매일 스크럼하고, 짧게 짧게 개발하고 개선하면 된다고 생각할수있지만, 

    실제로 진행해보면, 상당히 어려운 방법론이라는것을 알수있다.

    그이유는 “멤버들 모두에게 일정수준의 실력과 책임을 요구하는 극한의 개발론”이기 때문이다.

    누가한명의 마인드셋이 다른 멤버보다 떨어진다면, 누구한명의 실력이 멤버들보다 떨어진다면…

    생각보다 그 영향은 기존 방법론보다에서의 영향보다 크다.

    빠르고, 가볍고 민첩하게 치고 가야하는 레이스에서 누구한명이 그렇지 못하다면, 

    모두의 페이스가 뒤쳐지게 되기 때문이다.

    따라서, 애자일 방법을 하기위해서는 무엇보다도, 멤버들의 마인드셋과 실력의 파악이 중요하다…

    아무리 좋은 방법/도구가 있다고 해도, 그것을 사용하는 사람의 마인드셋이 영아니거나, 실력이 없다면 큰 시너지를 낼수가 없는것과 같다.

    초보운전자를 F1 자동차 드라이버로 앉히는것과 같다.

    그리고 애자일을 하는 프로젝트 멤버들 또한 애자일에 대한 디테일한 스터디가 꼭 필요하다…

    애자일은 사실 쉽게 이해가 되는 부분도 있어서, 굳이 깊게 스터디를 하거나, 심도있게 생각하지 않는 사람들이 많다.

    의도하는 대부분이 상식적인 수준이기에, 쉽게 접근하고 시도할수있는 방법이구나 생각을 하지만 (물론 나도 그랬다.)

    또는, 경험적으로 .. 이런것이 애자일이겠구나 라는 경험에 빗댄 상식으로 접근을 하는경우가 많다.

    하지만, 애자일 개발론 또한 위에 말한것처럼 오해할수있고, 유의해야하고, 알고있어야 시너지가 나는 부분들이 존재한다.

    이런 부분들은 책을 통해서, 습득하는것이 올바르고 빠른 방법이라고 생각한다.

  • [개발생각] 아파치 카멜 사용 후기

    아파치 카멜을 본격적으로 써봤다. 스프링배치를 사용하려고 했는데, 이런저런 이유로 아파치 카멜을 사용하게 됐고, 후기를 남겨본다

    카멜 vs 스프링배치

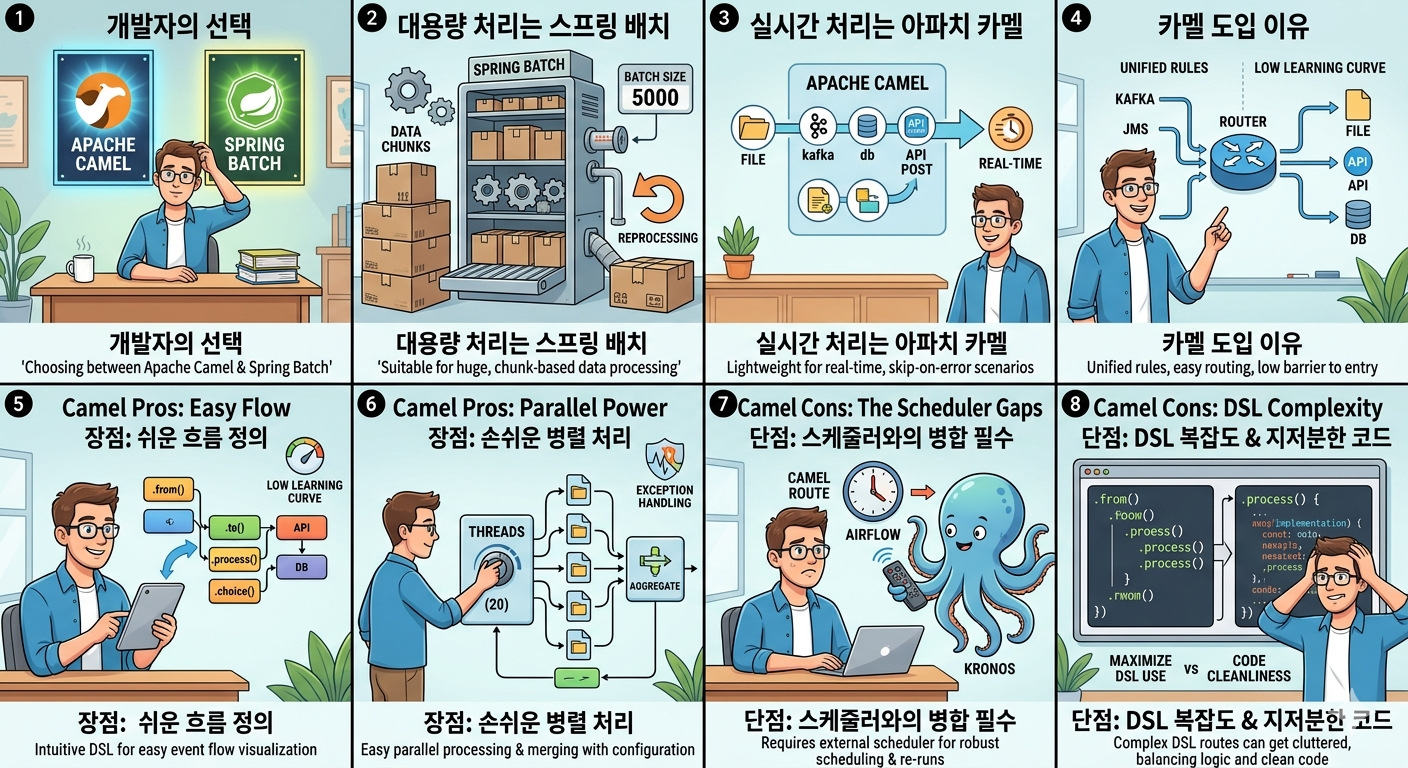
    카멜은 DSL방식의 이벤트의 흐름을 정의하고, 이벤트의 라우팅을 쉽게 해주는 여러 컴포넌트를 제공하기에,

    실시간성 이벤트 처리에 적합하다.

    스프링배치는 청크단위 배치사이즈단위의 롤백처리라던가 재처리등을 할수있고,

    이런 기능등을 활용하여 좀더 대용량처리에 적합하게 사용할수있다는 장점이 있지만,

    실시간성 처리 (즉, 실시간으로 바로바로 처리를 해야하고, 최악의 경우는 문제가 되는 데이터처리는 스킵하면서,

    실시간 처리를 해야할수도있는 경우)에는 다소 무거운, 그리고 러닝커브가 많은 솔류션으로 이해했다.

    내가 카멜을 도입한 부분은 위에 말한 장점을 살리기 위한 판단이었다.

    1) jms, file, api, kafka, db등을 통한 데이터를 reader해야하고, 또한 writer를 해야하는 경우가 많다.

    2) 각각의 router를 하나의 통합된 방식을 통해, 정리된 룰로 동작하도록 하고 싶다. (유지보수를 위해)

    3) 병렬처리/비동기처리등을 도입할때, 러닝커브가 최대한 없고, 직접 해당 처리를 제어하지는 않았으면 좋겠다.

    4) reader의 다양한 소스에 따른 쉬운 라우팅방식을 제공하는 솔류션이면 좋겠다.

    위의 판단으로 카멜을 사용했고, 그에 따른 후기는 아래와 같다.

    장점)

    1) 러닝커브가 상당히 적다. DSL을 통한 직관적인 이벤트의 흐름을 정의할수있어, 데이터의 흐름이 한눈에 보이게 된다.

    2) 병렬처리가 상당히 쉽다. 

    – 쓰레드설정을 해당 스텝에서 설정만으로 쉽게 적용이 가능하다.

    – 다양한 stream source에 대해서도, 쓰레드풀 설정을 쉽게 적용할수있다.

    – 병렬처리뿐아니라, 이후에 병렬처리된 데이트를 다시 어그리게이션하는 기능도 있기에, 데이터의 분산, 통합등을 자유자재로 제어할수있다.

    3) 예외처리와 서킷등의 기본적인 처리또한 일관되게 처리할수있다.

    – 글로벌 예외설정을 할수도있고, 서킷설정도 각각의 스텝에서 별개로 설정할수있다.

    4) 이벤트의 흐름에 따른 잡을 나눌수있고, 비동기로 처리되는 잡들을 동기처리와 동일하게 흐름을 쉽게 파악할수있게 잡을 설정할수있다.

    – 기존 listener, templete등을 이용하면, cosumer등이 분산되고, 처리 프로세스도 분산되기에 이벤트의 흐름이 한눈에 보이지 않지만,

    카멜은 DSL로 흐름을 정의해야하기에, 비동기 흐름도 한눈에 파악이 가능하다.

    단점)

    1) 에어플로우같은 스케줄러와 같이 사용을 해야할듯한다.

    – 스케줄링 솔류션을 같이 사용해야 강력하다. 자체적으로 리스타트나, 재처리등의 기능을 직접 구현해야하는 부분이 있기에, 이런 부분을 상쇄할수있는 스케줄러 솔류션을 같이 사용하는게 더 좋은것 같다.

    2) 병렬처리가 되면, 아래 이벤트 흐름도 모두 병렬프로세스의 스레드를 따라가기때문에, 병렬처리가 시작되는 부분과 끝나는 부분을 잘 관리를 해야하는 부분이 있다. (안그러면, 스레드풀 고갈 원인이 될수있음, 트랜잭션 문제가 발생하거나..)

    3) DSL로 흐름을 정의하다보니, 복잡하거나 반복되는 코드에 따라, 코드가 지저분해지는 느낌을 받는다.

    이건 성향이나 개인의 차이가 있겠지만, 구현코드가 service등으로 구분되지않고,

    DSL내에 process블럭에 코드가 작성되게 되니, 좀 지저분한 부분이 생긴다.

    (물론, process블록에서 service클래스를 호출하게 하면 된다.

    하지만, 내가 생각하는 좋은 방향은 최대한 DSL의 블록에서 표현을 하는것이 가장 좋은 방법이라고 생각을 한다.

    – 최대한 camel을 dsl문법을 활용)

    장단점이 있지만, 현재 사용한 후기로는 나름 좋은 중소형 이벤트 처리 솔류션으로는 좋은 포지션인것으로 보인다.