[작성자:] kun7788

  • [아이디어] 스크래핑으로 플로우 간단히 만들기

    외부 페이지 연동이 많은 서비스들은 상당 플로우가 복잡하기에, 사용자 이탈이 심하다.

    가입 한번해서 앱한번 사용하려면, 어디 페이지 로그인해서 동의하고, 어디 사이트 웹페이지 열어서 선택해야하고 등등…

    외부 연동 페이지에 종속적인 서비스들은 사용자의 이탈이 상당히 심하다.

    그렇다고, 서비스를 접을수도 없으니 고민이 많을것이다.

    이런 경우,

    쉽게 풀수있는 방법은 해당 외부 연동 서비스에서 oauth등을 지원하여, server to server로 연동을 하는 방법이다.

    하지만, 쉽게 oauth기능을 제공하지 못하는 곳도 많이 있기때문에, 다른 방법이 대안이 될수도 있을것같다.

    그 대안중에 하나가 ‘스크래핑’ 기술을 이용하는 방법이다.

    사실 단점이 명확하고 심지어 위험하기까지도 하지만,

    그 사용함에 있어서의 장점 또한 뚜렸하기에 나름 좋은 대안중에 하나라고 생각도 든다.

    이 스크래핑을 업체에 맡기면, 외주개발비와 함께, 건당 얼마와 같은 비용책정이 되는경우가 많다. ;;;;;;;;;;

    마치 봉이 김선달처럼, 개발비도 받고, 스크래핑 건당 얼마로 지속적으로 수익이 발생하는 아주 배아픈 현실이랄까?…ㅋㅋ

    이런 배아픔을 조금이나마 없애기 위해서,

    직접 스크래핑 기능을 만든다면, 어떻게 만들어야 할까? 생각해봤다.

    1) 클라이언트 베이스 스크래핑으로 만들어야한다.

    – 스크래핑을 서버에서 진행하는 경우, 잦은 접속을 하는 서버 아이피가 막히는 경우가 상당히 많기 때문에,

    이런 리스크를 줄이기 위해서는 클라이언트 (앱)에서 스크래핑이 동작하게 만드는것이 더 안전하다고 생각했다.

    2) 웹뷰 + javascript 브릿지 통신을 이용하여 구현한다.

    – 웹페이지를 자연스럽게 스크래핑하고 돔 접근이 가능한것은 웹뷰를 이용하는 방법이다. 그리고 해당 돔을 제어하거나, 조작하는 것은 브릿지 통신으로 구현하면 될듯한다.

    3) 돔접근에 대한 기본적은 룰은 서버에서 관리하고, 스크래핑 최초에 클라이언트가 서버에게 룰을 받아서 동작하게 만든다.

    – 웹페이지는 갑자기 개편이 되거나, 구조가 바뀔수 있기에 스크래핑룰을 클라이언트가 가지고 있으면, 빠른 대응이 어렵다.

    빠른 수정 대응을 위해, 서버에서 룰을 관리하고 클라이언트에게 동적으로 제공하는 방법을 제공하는게 안전하다.

    4) 그 룰은 기본적으로 아래와 비슷하게 만들면 될듯하다. – 어셈블리 언어와 비슷하게 만들면 될듯?!!

    - move "https://www.naver.com"
    
    - select id "login_id"
    
    - click 
    
    - wait onload
    
    - select id "address" 
    
    - click index 1

    이런식으로 명령과 그에 따른 파라미터 구성으로 룰을 만들면 어떨까?

    위에 내가 만든 명령은 대략 이렇다.

    naver.com으로 페이지를 이동하여, id가 login_id인 돔을 선택하여, 클릭하고, 페이지 로딩이 될때까지 기다린다. 그리고 id가 address인 돔을 선택하고 첫번째 항목을 클릭한다.

    좀 어셈블리, 기계어 같지않나? ㅋㅋㅋ

    이렇게 구성을 한 이유는 이 명령어를 AI프롬프트를 통해, 선언하고,

    AI에게 저 룰을 자동으로 만들어 내게 하여, 관리포인트를 줄이기 위함과 함께,

    해당 룰은 스택머신과 같이 한줄한줄 읽어가며 실행을 하면 되는 것이기에,

    해당 룰을 가지고 실제 구현체를 만들 클라이언트의 복잡함을 좀더 단순하게 할수있기 때문이다.

    이렇게 하면, 클라이언트 베이스 스크래핑을 만들수있을듯하다.

    물론 실제로는 될지 안될지는 다음 문제이겠지만, 우선은 머릿속에서 시뮬레이션을 돌려보면,

    가능하겠다라고는 생각이 든다.

    기회가 된다면 한번 만들어봐야겠다!!!! (봉이 김선달!)
  • [개발생각] 내가 생각하는 개발자란?

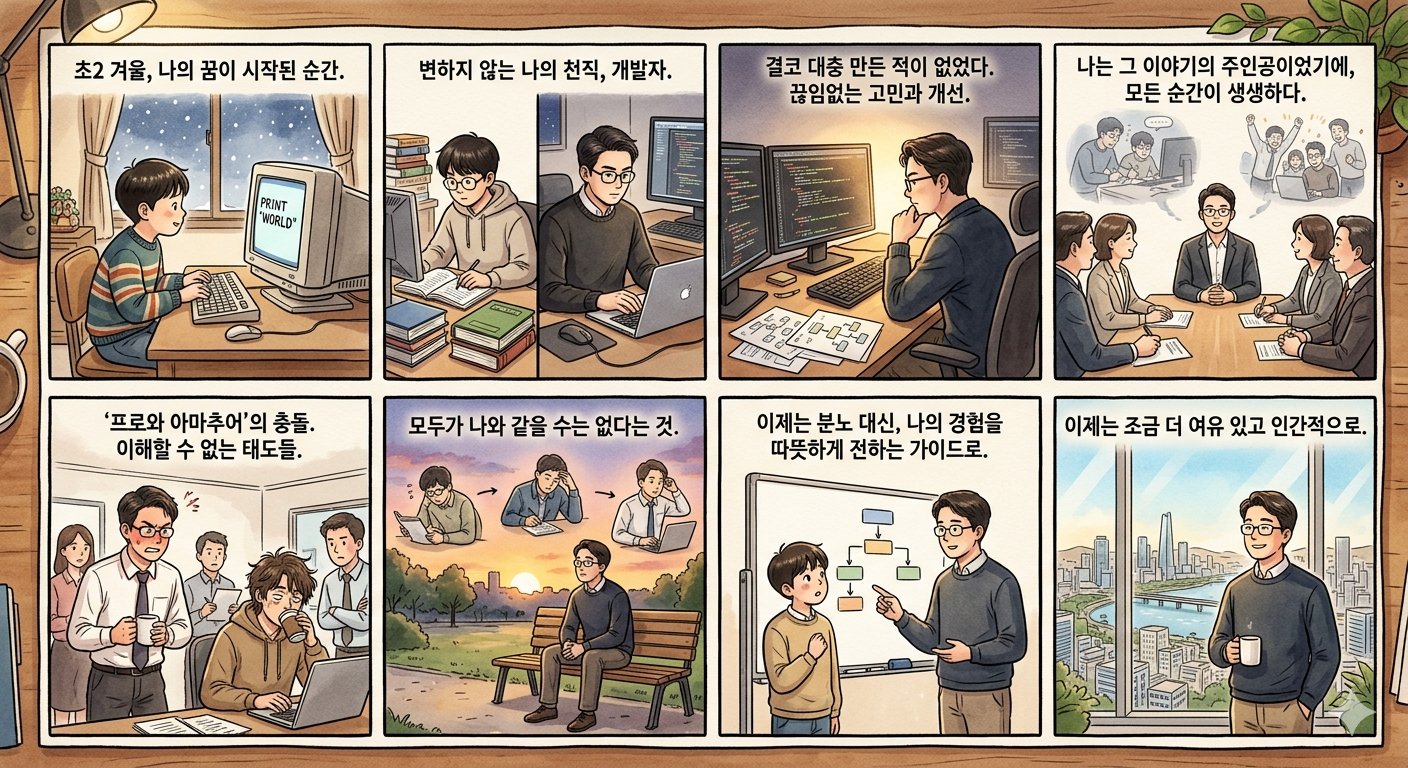
    초등학교 2학년 겨울쯤에 컴퓨터 프로그래머가 되기로 마음먹었고, 그 마음이 현재까지 한번도 변하지 않았었다..

    내가 가장 잘할수있다고 생각되는 부분이 컴퓨터 프로그래머, 개발자라고 생각했고, 그 생각은 아직도 변하지 않았다.

    현재도 딱히 다른걸 잘할수있다고도 생각이 들지 않는다.

    (사진,기타,게임 뭐 깔짝깔짝하긴했는데… 흥미나 실력이 잘 늘지를 않더라 ㅋㅋ)

    하지만, 개발에 대해서의 마음가짐은 누구보다도 진심이라고 생각한다.

    내가 만드는 서비스에 대해서,

    한번도 대충 만든다거나, 이정도면 됐다라고 생각하지 않았다.

    계속 발전시키고, 수정하기 위해서 고민했던것은 분명하다.

    예전에 면접을 본곳에서 면접자가 이런이야기를 한적이 있다.

    “엄청 예전일인데, 그당시 개발한 내용을 상당히 디테일하게 설명을 하시는군요, 준비를 많이 하셨나봐요”

    준비?!.. 내가 개발한, 경험했던 부분은 위와 같은 마음가짐/태도로 항상 임해왔기에, 

    마치 그때의 장면들이 아직도 생생하게 남아있기에,

    지금도 자세히 설명이 가능하다고 답변을 했다.

    마치, 누군가에게 이야기만 들은것과, 내가 그 이야기의 주인공이였던것과의 차이점 이라고 할까?

    인간은 직접 경험하고, 고민한 것에 대해서 쉽게 잊어버리지 않는다고 한다. 

    그래서 나또한 그때의 개발/경험/고민들이 아직도 생생하게 남아있고, 막힘없이 누군가에게 이야기할수있는듯하다.

    이러한 마음가짐으로인해, 누군가가 프로그래머답지 못한 태도를 보이는 부분에 대해서는

    상당히 분노(?!)하는 발작버튼(?)이 있다 ㅋ…

    내가 이렇게 신성시하고 인생에서 중요시한 이러한 직업에 대해서,

    프로답지 못한 접근을 하는 동료나 사람들을 보면, 이해할수가 없었다.

    (뭐…솔직히 지금도 그렇긴한다…사람 고쳐쓰는거 아니라는 말이있듯이 ㅎㅎ)

    마음속 깊은곳에는 “프로와 아마추어”라는 잣대가 항상 충돌했고,

    아마추어적인 태도를 보이는 사람에게는 상당한 분노가 생겼다.

    마치 나를 욕하는 느낌이랄까?!

    하지만, 이제는 좀 달라져야할것같기도하다…

    내가 생각하는것이 틀려서 달라지겠다는 말은 절대 아니다.

    (당연히 내가 생각하는것이 맞다고 생각한다)

    달라져야겠다고 마음먹은 부분은…

    모두가 나와같은 마음일수는 없다는것을 이제는 받아들여야할것같다.

    누군가는 큰 고민없이 ‘개발자’라는 직업을 선택한 사람도 있을것이고,

    누군가는 아직 실력이 부족하여, ‘능력’을 보여주지 못하는 사람도 있을것이고,

    누군가는 그냥 회사다니면서, 대충, 월급만 받으면 된다는 생각을 가지고 있는 사람도 있을것이다.

    이런 개인적인 부분까지를 내가 분노할 필요는 없지 않을까? 생각이 든다.

    나의 역할은 위에 내가 생각하고 고민해왔던,

    “개발자라면 이런 사람이여야 한다”고 생각하고 행동해왔던 경험을 잘 이야기 해주는 역할이라고 생각한다.

    그 경험/이야기를 듣고 깨닫고 응답하는 몫은 개개인에게 맡겨야한다고 생각이 들었다.

    개개인의 판단에 대해서, 가이드를 해줄수는 있지만 고치기는 상당히 힘이 든다는것 이제는 조금은 알것같다.

    판단/책임은 좀더 여유있게 개개인에게 맡기되,

    좀더 개개인의 마음에 와닿을수있게 좋은 방향과 방법에 대해서

    잘 설명하는 방법을 고민을 하는게 더 맞는 방향이라고 생각이 들었다.

    언젠가는,

    깨닫고 응답하는 사람은 좀더 발전하는 모습을 보일것이고,

    아닌 사람은 그에 따른 책임을 지고 고통을 받게 될것이다.

    현재까지는 프로팀에서도 꼴찌하는 선수를 프로가 아니라고 엄격한 잣대로 판단해 왔다면,

    그 선수도 프로이고, 다만 개개인의 각양각색의 이유로인해서 실력이 나오지않은것이라라고 생각하는게

    더 인간적인 접근이라고 할까?

    이제는 마음을 조금은 편하게 먹어야지!!

  • [개발생각] 트랜잭션 시간을 줄이자

    외부API 호출과 DB 저장업데이트 로직의 트랜잭션을 보장하기 위해, 외부API호출을 DB트랜잭션안에서 하는 방법을 많이 사용한다.

    일반적으로 많이 사용하는 방식이지만,

    때에 따라서는 좀더 다른방법으로 접근을 해야하는 경우도 있다.

    외부API호출이 초단위로 넘어가는 느린 호출인경우 또는 더 최악으로 스크래핑같이 수초~수십초를 기다려야하는 호출인경우는 트랜잭션에 묶지 않고 트랜잭션에서 분리하여 호출하고,

    문제가 있을경우, 보정을 해주는 방법으로 구현하는게 훨씬 시스템의 성능이나 안전성면에서 더 유리하다.

    외부 호출이 느려지는 경우,

    결국은 트랜잭셕이 길어짐에 따른 디비 커넥션 고갈을 가져올수있고,

    그에 앞서서, 웹리퀘스트요청의 타임아웃이 먼저 발생할수도있다.

    따라서, 외부 호출이 오래걸리는 작업인 경우는 트랜잭션영역에 포함되지않는 밖에서 호출을 하고,

    트랜잭션처리를 할수있도록 코드를 구성해줘야 안전하다.

    예를 들면)

    게시판을 만드는데, 게시글에 첨부파일이 업로드되고 해당 첨부파일은 멀티파트데이터를 받아서,

    s3에 업로드를 모두하고, 게시글을 db에 저장하는 흐름이라고 할때,

    첨부파일을 s3에 업로드하는 흐름까지는 트랜잭션에 엮이기 않게 별도로 처리를 해야한다.

    s3에 업로드가 모두 완료된 시점에 트랜잭션을 열어 db에 게시글을 저장하는 흐름이 되어야 할것이다.

    (절대 트랜잭션안에서 s3업로드하는 로직이 들어가면 안된다 ;;;)

    해결 방법으로는 코드를 통해 하는 방법도 있고, event방식을 통해 구현하는 방법도 있으니, 적절하게 골라서 사용하면 될듯하다.

    @TransactionalEventListener(phase = TransactionPhase.AFTER_COMMIT)

    TransactionalEventListener을  사용하면, 트랜잭션에과 별도로 처리를 더 유연하게 할수있다.

    외부호출이 비동기로 동작해도된다면, @Async를 설정해주면, 더욱 성능을 높일수 있을듯하다.

    DB에서 트랜잭션이 열리는 순간부터는 하나의 커넥션이 트랜잭션이 닫히는 순간까지 점유를 하게 되기때문에,

    항상 설계단에서는, 트랜잭션은 빠르게 열고, 빠르게 닫히는 방향을 항상 최선시 하여 코드를 구성해야한다.

    트랜잭션안에서 시간이 오래걸리는 행위(API호출, 작업)등은 최대한 피하는 방법으로 설계를 해야 성능을 높힐수있다.

    이 부분은 실무에서 많이 간과할수있는 부분이라고 생각한다.

    하지만, 간과함에 따른 문제가 발생하는 경우는 큰 문제로 번질수있는 원인이 될수있기에, 

    항상 머리속에 간직하고 있어야할 사항이라고 생각한다.

  • [아이디어] 대기열 기능 만들기에 대해서

    사용자가 갑자기 몰리는 기능, 특히 해당 기능이 무거운 경우 (외부 API연결, 스크래핑, 무거운 쿼리) 사용자의 기능 접근을 의도적으로 일정수준으로 제한을 해야하는 경우가 발생한다.

    이런경우, 대기열 기능으로 해당 문제는 해결할수있다. 

    대기열이란, RateLimiter를 구현하는것이라고 보면 될듯하다.

    세마포어를 이용해서, 내가 기능에 접근할 최대 횟수를 정하고, 항상 그 횟수안에서 기능의 접근을 허용하고 거부하도록 만드는 구현이다.

    (가게에 화장실이 x개있고, 사람들이 줄을 서서 화장실에 접근하는 개념 ㅋ)

    가장 일반적인 방법은 Redis의 Zset을 활용하는 방법이 있다.

    이 부분은 AI에이전트들에 물어보면 상세하게 알려줄것이라, 구현의 어려움은 없겠지만, 우리는 어떻게 운용을 해야하는가를 고민해야한다.

    이 영역이 인간 개발자의 가장큰 역할이지 않을까? ㅋ

    우선 대기열에 접근할수있는 횟수를 정하는게 가장중요하다.

    과연 어느정도로 접근제한횟수를 정할것인가?!

    1) 해당 기능의 평균 실행 시간을 측정해야한다.

    2) 스레드풀과 디비풀 사이즈를 감안하여, 해당 기능의 실행횟수가 최적의 상태가 되도록 TPS를 산정한다.

    3) TPS를 이용하여 대기열의 최대횟수를 정의한다.

    4) 사용자가 대기해야하는 최대시간을 정한다.

    여기서 4)번이 가장 중요하다.

    예를 들어, 1초에 10명의 사용자가 해당 기능에 접근하게 설정을 해두었다고 가정한다면,

    사용자의 대기시간을 2초만 대기시켜도 TPS가 20명, 3초만 대기시키면, TPS가 30명으로 늘어날수있다는 이야기가된다.

    여기서 사용자가 불편함, 대기한다고 인지할수없는 짧은 시간은 어느정도인지를 선택하는게 가장중요하다.

    해당 시간동안에는 대기열 정보 (xxx명중에 xx째 대기중 이런 정보)를 보여주지 않고, 해당 시간동안 대기하고 진행하게 하면 그짧은 시간으로 인해 TPS가 20명, 30명으로 늘릴수있는 효과를 볼수있다.

    (사용자는 어? 좀 느리네 라고 인지하는 정도)

    그리고 그 이후에는 대기열 정보를 보여주어, 사용자에게 명시적으로 지금 사용자가 많으니, 대기를 해야하고 몇번째 대기중이다라고 보여주는 프로세스로 구성을 하면 더 효율적인 대기열을 만들수있다고 생각한다.

    사용자에게 조금 느리다는 인지정도의 작은 불편함을 주면서 시간을 확보하여 TPS를 늘리고, 대기열을 보여줌에 따른 사용자의 이탈(오래걸리네..라고 생각하는 사용자)을 막을수있다고 생각한다.

    서비스를 개발 하는데는 공학적인 아이디어도 중요하지만, 인문학적인 아이디어도 정말 중요하다고 생각한다. 결국 인간이 해당 서비스를 사용하고, 거기서 감정과 감성을 느끼게 되기 때문이다.

    대기열을 구현할 상황이 오면, 이런식으로 한번 만들어 봐야겠다.

    *키포인트 : 사용자가 눈치채지못할 시간동안에는 대기열을 보여주지않고, 대기시킴으로써 TPS를 늘린다. 그 이후 대기열을 보여준다!!

  • [개발생각] 게시판 JPA로 구현할때, 정해야 할것들

    예전에 신입 개발자 뽑을때, 게시판 만들기 코딩 과제 많았다고 하던데, 왜인지 알겠다 ㅋㅋ.. 

    간만에 게시판을 만들어봤는데, 정말 어렵다. 구현이? 아니..

    대량의 호출에도 느려지거나 허무하게 죽지않을 정도로 성능이 나도록 만드는게 정말 어렵다.

    어렵다기 보다, 고민 포인트가 정말 많았다.

    우선 고민 포인트 몇가지가 있었다.

    1) JPA의 관계설정을 사용해야할까?

     게시판은 게시판, 포스트, 포스트의 댓글, 그리고 댓글의 댓글등, OneToMany, ManyToOne 의 관계설정이 많이 들어간다.

     관계설정을 통해, cascade설정을 하여, 데이터의 저장/삭제등의 동기화를 일관적으로 맞추고,

    관계설정에 따라, 알아서 댓글 또는 대댓글등을 불러올수있기에, 상단한 매력으로 다가온다..

    하지만, 편한만큼, 조회 기능에 많은 공을 드려야하고, 성능 튜닝을 할수있는 포인트가 줄어드는것은 어쩔수없는듯하다.

    조회에서는 관계설정을 통해, N+1 문제에 따른 fetch join쿼리를 항상 염두해두어야하고,

    관계설정에 따라 데이터 조회가 이루어짐에 따라, 쿼리 튜닝이라던가, 캐시사용에서 제한되는 부분이 존재하게 된다.

    결론 : 관계설정을 하지않고, 별도의 쿼리를 통해 게시판을 구현한다.

    물론 단점도 있겠지만, (아마 큰 단점이라면, 데이터 정합성과 구현의 복잡함일듯하다),

    구현을 잘 정리하여 만들수있다면, 어느정도 단점은 극복할수있다고 생각했고, 관계설정을 하지않음으로 해서,

    성능상 문제가 발생할수있는 부분에 대해서, 직접 방법을 선택하여 적용할수있기에

    성능을 극한으로 끌어올릴수있는 장점을 위해서는 일부 고통(?!)을 감수해야만 한다고 생각했다.

    (캐시, 블룸필터, 댓글, 대댓글을 별도 호출로 분리등등)

    2) 쿼리를 최대한 묶어서 벌크로 요청한다.

    관계설정을 하지않고 직접 쿼리를 날리거나, 레디스를 통해 댓글, 태그정보등을 저장할때,

    가장 중요하게 생각해야하는 부분은 이런 요청을 최대한 묶어서 한번에 요청하여 사용하는 방법을 통합해서 사용해야,

    관계설정을 하지않고, 개발자가 메뉴얼로 조회를 하는 방법에서 오는 성능 향상을 극대화 할수있다.

    예를 들어)

    게시글 목록 조회 기능을 만들때, 기본적으로
    
    게시글 목록 조회 (N개 1번조회) + 게시글에 따른 태그 조회 (레디스 조회 N번) => 1 + N 번


    이것을 만약,
    
    게시글 목록조회 (N개 1번조회) + 게시글들에 따른 태그 조회를 한번에 리스트로 요청 
    (레디스 PIPE명령을 통해, 복수개의 태그정보 조회요청 1번) => 1 + 1 번

    1+N번 > 1+1번

    2번의 호출로 1+N번 호출하는것과 같은 결과를 얻을수있다.

    여기에 대댓글이나, 첨부파일조회등의 조회가 더들어간다고하면, 그 조회의 횟수차이는 더욱더 나게 된다.

    이렇듯, 조회의 횟수를 줄이는 방법을 항상 고려해야 성능상의 이점을 얻을수있다.

    내가 만든 게시판은 목록조회 1번 + 태그조회 1번 + 댓글조회 1번 => 총 3번으로 페이징목록에 대한 요청을 모두 처리하도록 구현했다. 

    생각없이 만들면 아마

    N개 목록조회 1번 + 태그조회 N번 + 댓글조회 N번 => 1+2N번 호출을 해야 가능한것을 3번으로 줄이게 되는것이다.

    3) 게시판의 모든 데이터는 데이터베이스에 꼭 저장해야할까?

    습관적으로 데이터베이스에 데이터를 저장하는 방법을 우리는 사용하고 있다.

    뭔가 이런방식이 데이터가 사라지거나 유실되지 않느다는 과거에서의 학습에서 오는 안도감이랄까?

    데이터베이스에 들어가는순간 데이터는 안전해~~ 라는 느낌..

    하지만 시대를 바뀌었고, 클러스터링이 가능한 플랫폼들이 나왔고, 데이터 유실을 막아주는 여러 방식이 나오게 되었다.

    그중에서 레디스도 퍼시스턴스를 안전하게 지원하는 여러 방법이 존재한다.

    RDB, AOF등의 옵션을 통해, 최대한 데이터의 유실을 막을수있고, 서버다운등에 따른 데이터 복구도 할수있다

    (물론, 복구에 따른, 시간/리소스의 투여는 감안해야한다. – AOF복구는 많이 느림..)

    레디스를 적극사용하기로 했다.

    특히 태그, 읽음표시, 댓글수등에는 레디스의 자료구조를 최대한 활용하여, 데이터베이스에 직접 저장을 하지않고,

    레디스에 저장을 하는 방법을 사용했다. 레디스만으로 구현을 하였고, 만에 하나,

    레디스 복구가 어려운 경우는 충분히 데이터베이스를 통해 복구가 가능한 부분을 파악해 두도록 했다.

    이제는 만들일 없겠지?…ㅋ

  • [개발생각] 공지글 읽음 처리에 대해서..

    사용자가 공지글을 읽으면, 그 공지글을 읽음처리하려면 어떻게 해야할까? 참 어렵다…

    대부분의 개발자들은 이게 뭐가 어려워!

    테이블에 유저아이디, 공지글아이디 기준으로 읽음여부 Y/N저장하고 공지글하고 조인해서 여부 같이 붙여서 처리하면 되지!! 하는 사람도 있을것이고… 어렵다고 고개흔드는 사람도 있을것이다.

    어렵다고 고개흔드는 사람이 나는 더 낫다고 생각한다.

    (그래도 성능을 생각했을 확률이 높은 사람이 이 사람일지도 몰라서..ㅎ, 아니면 정말 모르는건가!!!)

    데이터베이스에 넣는 방식은 누구나 생각하겠지만, 상당히 안좋은 방법이다.

    만약 100만명 유저가 있고, 공지글이 100개가 쌓여있다고 한다면, 데이터베이스 크기는 어떻게 될까?

    최약의 경우 모든 유저가 공지글을 읽었다고 하면, 100만x100개의 데이터베이스 ROW가 생긴다.

    그리고 일반적으로 60%정도가 공지글을 읽는다고 해도 60만x100개의 데이터 베이스 ROW가 생길것이다.

    6000만 ROW다..그리고 이 데이터는 지속적으로 늘어난다..공지글을 쓰면 쓸수록..

    데이터만 어마어마하게 늘어나는게 아닌, 조인을 통한 사용에서도 문제가 발생할수있다..(성능 개판!!)

    더불어, 주기적으로 일정 기간이 지난 데이터는 지우는 전략은 기본으로 가져가야 할것이다.

    우리는 먼저 문제의 핵심을 파악해야한다.

    과연, 6000만 ROW씩을 데이터베이스에 저장할만큼 공지글 읽음 처리가 중요한 기능일까?! 

    대부분은 중요한 기능/데이터가 아닐 확률이 크다.

    심지어, 유저는 있는지도 모를확률이 크다..쩝;;

    그렇다면, 좀더 효율적이고, 자원/속도에 이득이 되는 방법을 생각해봐야한다는 결론이 나온다.

    여기서 가장중요한것!! HBASE나 클러스터링에서 자주쓰는 그놈!!!

    블름필터 알고리즘을 쓰는 방법이있다.

    이거 예전에 완벽하게 이해했는뎅 ㅠㅠ 까먹었다…

    간단하게 여러개의 해시테이블을 이용하여, 저장할값을 해시한 값을 여러 해시테이블에 저장한다,

    그리고 조회를 할때도, 조회할 값의 해시값으로 멀티 해시테이블에 조회하여, 모두 존재하는지를 확인하는 알고리즘이다.

    사실 동작방법은 크게 어렵지않고 간단하다.

    정확도를 높이면서, 값이 있는지 없는지를 확인하는 알고리즘이다.

    여기서 해당 블름필터에 값을 넣고, 조회했을때,

    값이 없다고 나오면, 정말 없는것이 100%확률로 맞고,

    있다고 한다면, 오차범위(정할수있음)의 확률로 없을수도 있다.

    이 알고리즘을 이용하면,

    기존 데이터베이스에 저장해서 공지글 읽음을 하는것보다 30배는 더 적은 데이터/메모리를 가지고

    공지글 읽었음을 저장하고 조회하여 판단할수있다.

    여기서 중요한게 블름필터는 어떤 기준으로 만드느냐는게 중요한데,

    그 갯수가 크지 않은 기준(크기가 작은 기준)으로 만드는게 중요하다.

    즉, 유저기준으로 만드는것보다는 상대적으로 그 대상이 적은 공지글기준으로 블룸필터를 만드는게 유리하다.

    (여러개의 블름필터를 관리해야하는 관점에서 관리대상이 적도록 기준을 잡는게 중요하다)

    블름필터는 코드베이스로도 쉽게 쓸수있고, 영속성이 필요하다면, 가장 쉬운 레디스를 통해서도 가능하다.

    (redisson 좋다!)

    그리고 공지목록에 공지아이디 기준의 블름필터에 유저아이디로 조회를 하여, 해당 공지글을 해당유저가 읽었는지를 확인하여,

    공지글에 읽음여부를 붙여서 API응답하게 만들면 된다.

    여기서 중요한점!

    공지글별로 블름필터를 레디스로 조회해야하기에, 레디스 통신이 공지글 갯수만큼 호출되게 된다.

    이부분도, 레디스 파이프실행으로 묶어서 한번에 호출하도록 하여, 네트워크 통신비용을 한번으로 줄여서 그 효율을 극대화해야한다.

    또한 공지글 목록이 과도하게 많을수있기에, 적절한 청크로 나눠서 파이프실행을 해야, 문제가 없을것이다.

    어떠한 기능을 만들때는 정직한 방법만이 꼭 정답이 아닌 경우도 많다.

    위 공지글 읽음같은 경우가 그 예라고 볼수있다.

    개발자는 주어진 기능에 대해서 판단하고,

    전제조건/필요조건의 수정을 통해 더 큰 이득을 얻을수있는지를 파악하는 능력또한 중요하다.

    너무 정직하게만 개발을 하지말자..

    그건 그렇고, HBASE에서 블름필터 공부한게..벌써..몇년이나 된거야 ㅠㅠ

  • [개발생각] StructuredTaskScope에 대해서

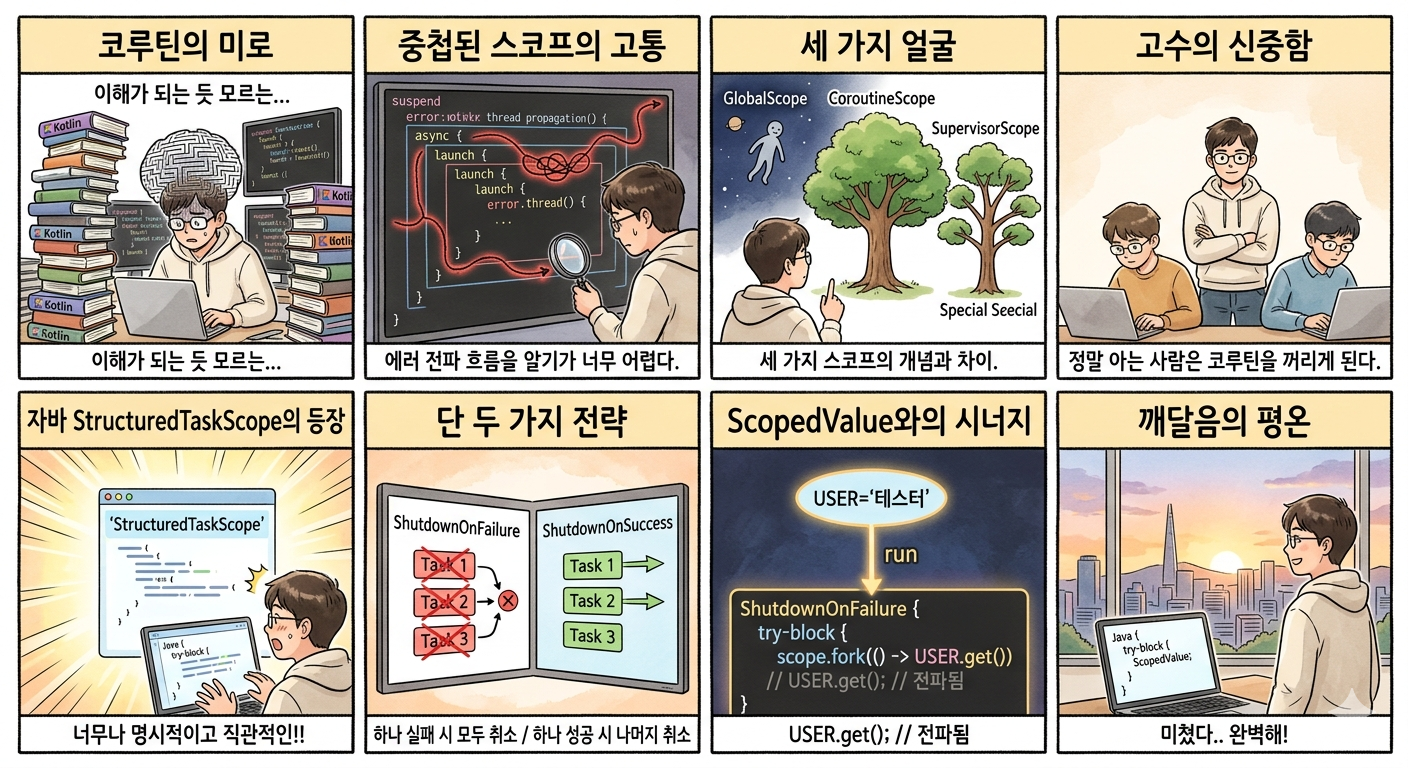
    와.. 항상 코틀린이 문법적으로 더 깔끔하다고 생각했는데.. StructuredTaskScope 보고, 그렇지만은 안다는걸 느꼈다..

    코틀린을 하면서, 어렵고 난해하다고 생각하는 부분/기능이 코루틴이였다.

    그 개념을 이해하는데, 정말 시간이 걸렸다.

    이해한거같은데, 모르겠고, 모르겠는데, 이해되는 부분도있고 하는 애매한 상태가 오래됬는데,

    관련 코틀린책을 3번 정도 읽으니, 이해를 마침내 되었다.

    그래도 코루틴에서 난해한 부분이 “구조화된 동시성”에 대한 기능에 대한 이해였다.

    이해는 되지만, 사용법이 깔끔하지 않다고 할까?

    특히 코드 블럭이 중첩되는 경우에 “구조화된 동시성”에 따른 동작 흐름을 판단하는건 많이 복잡했다.

    DB 트랜잭션 전파(Propagation)와도 비슷한 맥락이랄까? ㅋ

    암튼, 코틀린은 개인적으로 생각할때,

    코틀린의 설계가 그렇게 썩 나이스한 설계는 아닌것 같다는 생각은 평상시에 자주한다.

    중첩되는 경우나 suspend에 의한 스코프 변경에 따른 구조화된 동시성 구조를 파악하기가 너무 어렵다.

    아마 함수단위로 코루틴을 설정한 부분에서 트레이드 오프가 아닐까 한다.

    함수단위로 코루틴을 구현하면,

    스택머신의 상태값을 함수인자로 전달받게 비교적 간단하게 구현을 할수있다는 장점이 있지만,

    중첩된 스코프에서 오는 복잡함은 단점이 된다고 생각한다.

    (함수와 함수의 연결된 흐름이 결국 비즈니스 로직이니..복잡할 수밖에)

    개인적인 생각이 하나있다.

    코루틴을 정말 잘모르는 사람일수록, 쉽게 사용하려하고, 별것아니라고 생각한다..

    하지만 정말 코루틴을 잘 이해하는 사람은 코루틴을 사용하는걸 꺼리게 된다…그 위험성과 어려움을 잘 알기때문이다..

    암튼, 간단하게 코루틴에서는 “구조화된 동시성”을 제공하는 스코프 함수가 크게 3가지 있다.

    여기서 “구조화된 동시성”이란 여러 함수가 다른 스코프(함수/쓰래드등)에서 병렬/동시 처리가 되는 경우,

    구조적으로 에러에 대한 전파나, 함수의 성공여부를 어떻게 전파하고 처리하느냐에 대한 부분이다.

    1) GlobalScope

       – 해당 스코프안에 코루틴은 에러발생시, 부모에게 에러를 전파하지 않는다.

    (더 정확히는, 구조화가 안되있어서, 사실 부모가 없다, 그냥 모두가 자식인 상태이다)

    (즉, 부모 스코프에서 에러를 알수없기에, 에러처리가 불가하다)

    2) CoroutineScope

      –  해당 스코프안에 코투틴에서 에러발생시, 부모에게 에러가 전파된다.

    (부모 스코프에서 에러가 전파되기에, 에러에 대한 성공/실패처리 가능하다)

    3) SupervisorScope

    – 해당 스코프안에 코루틴에서 에러발생시, 부보에게 에러가 전파되지 않는다.

    이런 개념을 알아야, 구조화된 동시성에 맞게 코루틴을 잘 사용할수가 있다.

    그런데, 비슷한 개념으로 자바에서는 StructuredTaskScope 라는 기능으로 구조화된 동시성을 제공하고 있다.

    뭐랄까..

    훨씬, 문법적으로 깔끔한 느낌이다. 와!! 정리가 잘되있고, 명시적이고 직관적이랄까?!

    StructuredTaskScope의 전략은 크게 2가지가 존재한다. 2가지만 잘 사용하면 된다. 깔끔하다!!

    1) ShutdownOnFailure

    – 자식이 여러개가 존재할때 하나라도 실패하면, 나머지 자식도 모두 실패, 취소된다.

    2) ShutdownOnSuccess

    – 자식들중 하나라도 성공하면, 나머지 자식들은 모두 실패, 취소된다.

    – 동일한 API가 있는데, 먼저성공한걸 사용하는 기능만들때 참 좋겠다

    (ex: 주소API가 2가지가 있는데, 2가지 호출해서 먼저 성공한 호출을 사용하도록 구현)

    실제 사용예)

    try (var scope = new StructuredTaskScope.ShutdownOnFailure()) {
    
    var user = scope.fork(() -> getUser());
    var order = scope.fork(() -> getOrders());
    
    scope.join();
    scope.throwIfFailed();
    
    return combine(user.resultNow(), order.resultNow());
    }

    충격이다..너무 깔끔하다 ㅠㅠ

    그리고 가장 중요한 ScopedValue와 StructuredTaskScope를 같이 사용하여,

    ScopedValue를 다른 코드블록으로 전파하여 사용가능하다.

    ScopedValue.where(USER, "테스터").run(() -> {
    
    try (var scope = new StructuredTaskScope.ShutdownOnFailure()) {
    
       scope.fork(() -> {
          return USER.get(); // 전달됨 
       });
    }
    });

    아마 위의 코드 보면, 아!! 하지않을까?…

    미쳤다..

    ScopedValue와 StructuredTaskScope를 같이 사용하면 엄청난 시너지가 나는구나…

  • [개발생각] 스크럼의 진정한 목적이 무엇일까?

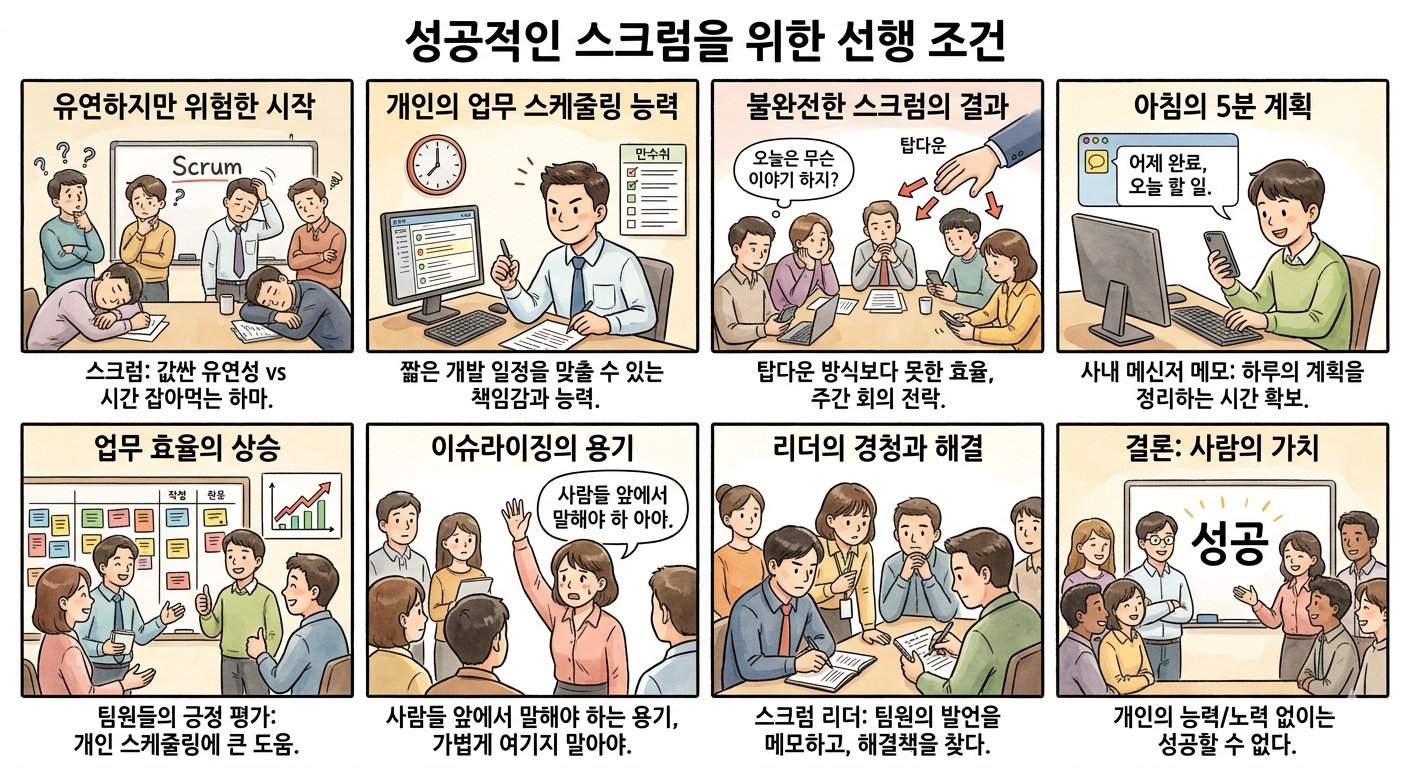
    스크럼은 가장 값싼 비용으로 유연한 개발문화를 만들수있는 방법중에 하나라고 생각한다.

    하지만, 스크럼의 진정한 목적을 모르고, 진행을 하면 그냥 시간잡아먹는 하마와 같이 변할수도있다.

    스크럼을 잘하기 위해서는 몇가지 갖추어야할 선제조건들이 필요하다.

    (값싸지만, 미리 선행되야 하는 조건들은 비싸다!!! ㅋㅋ)

    1) 팀원들은 개인의 업무에 대해서 스케줄링을 할수있어야 한다.

        – 스크럼을 시작할수있는 전제조건은 개개인이 자기가 맡은 역할에 대해서 최선을 다하고,

           최선을 다하는것을 넘어서 일정을 철저히 지킬수있는 책임감을 가지고있어야 비로소 스크럼을 할수있는 조건이 된다.

           스크럼은 빠르게 토론하고 빠르게 만들고를 반복하는 애자일 전략의 한 방법이다.

           따라서 빠르게 변화하는 짧은 개발 일정을 맞출수있는 능력이 되지않으면, 스크럼은 팀원에게 부담으로 다가온다.

       – 개인의 업무 스케줄링이 되지않는 상태로 스크럼을 하면, 일반 주간회의와 별반 다르지 않게 된다.

       – 오늘은 무슨이야기를 하지? (내일 뭐먹지와 동급)라고 생각하게되고, 스크럼을 불필요한 시간으로 간주하게 된다.

       – 이런 팀원들이 다수가 존재한다면, 스크럼, 애자일보다 오히려 탑다운방식이 더 효율적일수있다.

          (탑다운방식으로 스케줄링 실력을 올리고, 스크럼,애자일 방식으로 넘어가는게 더 나은 선택일수 있다)

    2) 팀원들은 스크럼을 통해, 내가 하는 업무에 대한 계획을 세워서 이야기하고, 지키는 노력이 필요하다.

         – 예전 회사에서 스크럼을 하기전에, 사내메신저에 간단하게 오늘 무엇을 할것인지,

            어제는 그날 해야할일을 모두 끝냈는지를, 간단히 메모하도록 한적이 있다.

         – 귀찮게 왜 하냐는 사람도 있었고, 성실하게 따라주는 사람도있었다.

         – 결론적으로는 대부분의 팀원들이 좋은 평가를 내렸다.

            하루의 계획을 아침에 짧게 생각하고 정리하는 시간을 확보해줌에 따라, 업무효율이 많이 올라갔고,

            개인의 업무스케줄링에 많은 도움이 되었다는 피드백을 받았다.

            (이때…상당히 뿌듯했지 ㅎㅎ)

    3) 스크럼 리더는 팀원들의 스크럼시 발언에 대해서, 기억하고 메모하여, 이슈라이징을 통해 문제를 해결해야 한다.

          – 스크럼 리더는 스크럼시에 멤버들이 이야기하는 이슈들에 대해서 결코, 가볍게 여기지 않아야 한다.

          – 스크럼 진행시, 사람들 앞에서 말해야하는 용기가 필요한 만큼, 이런것을 감수하고 많은 사람들에게 이슈라이징을 하는 내용이라면,

             정말 문제가 있는 경우가 많기때문에, 리더는 기억하고 메모하고, 해결책을 찾는것을 놓치지 말아야한다.

          – 몇번 별것아닌듯 넘어가면, 그 팀원은 다시는 이슈라이징을 하지않을것이다…

    모두가, 애자일, 스크럼, MVP모델을 외친다…

    그만큼, 요즘 세상에 접하기 쉽고, 너도나도 하는 방법이고 방식이기 때문일것이다.

    하지만, 명심해야한다.

    시작하기는 쉬워도 잘하기는 어려운것중에 하나가 스크럼이다.

    값싸게 접근할수있지만, 그 방법을 실행하는 사람 또한 값싼 사람으로는 할수 없는것이 스크럼이다.

    결론,

    개인의 능력/노력없이는 어떤 좋은 방법이든…실패할수밖에 없다..

  • [스터디] 자바 ScopedValue에 대해서

    ScopedValue 와! 이거 좋구나!! 스터디 잘해서, ThreadLocal의 찝찝함을 없애야겠다..

    자바 26릴리즈 노트를 최근에 봤는데, 쭉 내용을 보던중에 눈에 띄는게 있었다. 그게 ScopedValue와 StructuredTaskScope였다.

    우선 ScopedValue가 가장 맘에 들었다 ㅋ

    ThreadLocal를 대체할수있는 개념이였기에 큰 흥미가 생겼다.

    평상시, 나도 ThreadLocal의 사용성이나 사용법이 개발자의 실수를 만들어내기에 쉬운 구조라고 생각을 자주했기 때문이다.

    (ThreadLocal사용할때, 아..쓰기싫다 이러면서 쓴적도 많긴하다 ㅋㅋ)

    음,, 뭐가 맘에 들지않았냐하면 ..ㅋ

    1) ThreadLocal의 실행 라이프사이클이 Thread를 따른다는것이다.

    – Thread의 라이프사이클은 사실 런타임에서 돌아가는 개념이기에,

    ThreadLocal이 Thread의 라이프사이클과 동일하다는 개념은 코드상으로는 개발자가 쉽게 판단/유추하기가 매우 어렵다.

    특히 스레드풀을 사용하는 로직에서는 더더욱 어렵다.

    해당 코드블록이 어떤 스레드에서 동작하는것인지를 매번 머리속에서 상상하고, 쓰레드가 섞이거나 하는 경우를

    매번 주의해야하기때문이다.

    – Thread의 라이프사이클은 명시적으로 코드로 확인가능한 코드블록이여야 한다고 생각했는데,

    (마치 Try-catch-finally처럼 명시적 코드 블록) 이게 이번에 ScopedValue이 그 개념과 같았다.

    얼마나 기뻤는지…(나랑 같은 생각을 했구나, 자바SDK 개발자분들 ㅠㅠ 같은 생각을 하는 동지를 만나면 기쁘지않은가!)

    2) ThreadLocal에서 명시적으로 Remove호출하는 부분이다.

    – 이것또한 위 1번내용과 비슷한데, Thread의 라이프사이클을 주의깊게 사용해야함과 동시에,

    ThreadLocal의 주기의종료 또한 개발자가 직접 관리를 해야하는 것이다.

    개발자가 코드로 관리한다는 부분은 좋은 방법이라고 생각하지만,

    그 호출시점이 Thread의 런타임의 상태(어떤 Thread를 사용하는지의 판단)에 따라,

    개발자가 직적 remove 호출을 해야하는 부분은 너무 많은 실수를 양산할수있는 위험한 방법이라고 생각했다.

    – 이부분이 이제 ScopedValue를 통해 라이프사이클이 해당 코드블록에서 생성되고, 소멸되는 방법으로 제공하기에,

    명시적으로 Remove를 할필요가 없어졌다!! (마치 코드블록에서 로컬변수를 사용하는것처럼)

    가장 맘에 드는것이 ScopedValue개념이 Thread의 라이프사이클과 이제는 영영 안녕했다는것이다.

    Thread의 라이프사이클과 주기를 같이하는 기존 ThreadLocal은 ThreadPool을 사용하는 구조에서는 그사용이 정말 헬이라고 생각하기때문이다. Thread풀처럼 Thread를 얻어서 다른 로직을 수행하고 반납하고를 반복하는 구조에서는 자칫 잘못하면, 엉뚱한 ThreadLocal로컬값을 사용할수있기때문에, 정말 위험한 개념이긴하다.

    이게 아마..다음 커뮤니케이션에 일할때, 메일에 다른 사람메일이 막 뒤죽박죽 보였던 큰 사건이 있었는데…

    (그당시 해당 회사에 다니고있었는데.. 말그대로 회사가 기자들로 쑥대밭이였다…)

    그때 기억에 원인이  ThreadLocal + ThreadPool조합에서 해당 ThreadLocal에 개인정보를 저장해서 사용하면서, ThreadPool에 Thread반환시 Remove로 해당 데이터를 명시적으로 삭제를 하지않고 반환하여, 다른 사용자가 해당 Thread를 획득해서 사용시, 삭제되지 않은 다른 유저의 데이터를 사용하게 됨에 따라 문제가 발생했던것으로 기억을 한다… 어마무시하지않나..ㅠㅠㅠㅠㅠ 무섭다..

    앞으로 개발할때,

    ThreadLocal을 사용해야하는 경우가 발생한다면, ScopedValue을 이용하도록 해야겠다.

  • [개발생각] AI가 개발을 망치는 중이야

    악뮤가 쇼미더머니에 나와서 “쇼미더머니가 세상을 망치는 중이야”라고 노래한적이 있다.. 랩퍼들이 모두 분노했는데..

    요즘 AI가 발전함에 따라, 개발에 AI를 도입하는 개발자들이 많다. 나또한 잘 이해가 되지않는 부분이나 버그등을 예전에는 Stack Overflow 를 통해 찾았다고 하면, 요즘은 AI를 통해 해결책을 찾는다.

    이런부분은 참 좋은 방향이라고도 생각된다. 어차피 AI가 Stack Overflow의 내용을 모두 학습하여 판단하여 답변을 주기에, 좀더 종합적인 의견을 받을수있는 AI에 묻는게 해결책을 찾는 시간을 줄일수있기때문이다.

    하지만, 개발에서 내가 싫어하고 경계하는 AI사용법이 있다.

    AI에게 개발을 시키고, 그 개발을 어떤 코드리뷰와 분석없이 바로 실무(프로덕션)에 반영하는 행위이다. (이건 강도높게 개발이라고 하지않고, 행위라고 하겠다)

    이렇게 AI를 활용하는 대부분은 지속적으로 똥을 싸고 양산하는 코더일뿐이다.

    AI에게 개발을 시키는 행위를 위해, 프롬프트를 정리하고, 개념을 AI에게 숙지시키는 일련의 작업을 개발이라고 생각을 하며 자기 방어를 하겠지만, 이 부분은 개발이라는 큰 범주안에서 마땅하게 개발자가 해야하는 작업중에 하나일뿐이지, 전부가 되어서는 안된다.

    개발자는 개발을 위한 설계(위 프롬프트등)와 해결책 그리고 현실적인 장벽에 의한 회피 기술등을 해결해가는 사람이다.

    그렇기에, 코드리뷰나 AI로 생성된 코드에 대한 분석없이 프로덕션에 복붙하고