[작성자:] kun7788

  • [개발생각] 우수한 개발 집단이란?

    개발력이 우수한 집단에는 공통된 특징이 있다. 

    기획자 집단과 개발자 집단이 모두 우수하다는 것이다.

    개발력이 우수하다는것을 일반인들은 단순히 개발자들이 뛰어나서, 뚝딱 무언가를 잘 만들어 낸다는것으로 착각한다.

    하지만 개발자들이 서비스를 잘 만들기 위해서는,

    각자의 실력이 뛰어나야 함은 기본이고,  잘 기획된 기획서가 필수가 되어야한다.

    아무리 우수한 병사들이라도, 이 산,저 산으로 목적성없이 이동하면 힘이 빠지는 경우랄까?

    따라서, 잘 만든 서비스를 위해서는,

    기획자 집단의 서비스에 대한 꼼꼼한 기획서는 필수가 된다.

    내가 개인적으로 생각하는 각 집단의 역할은 명확하다.

    1) 기획자 집단
    
    - 만들려는 서비스를 '문서'로 만들어 내는 역할이다.
    
    - '문서'를 보면, 서비스가 A-Z까지 모두 파악이 되는 꼼꼼한 기획서를 만들어야 한다.
    
    - 개발에서 '인터페이스' 개념이라고 할까? ㅋ


    2) 개발자 집단
    
    - 만들려는 서비스를 '코드'로 만들어 내는 역할이다.
    
    - '코드'를 통해, 기획자가 의도한 기능들을 꼼꼼하게 빠짐없이 실제 구현해 나가야하는 역할이다.
    
    - 개발에서 '구현체' 개념이라고 해야겠다 ㅋ

    이렇듯, 기획자는 ‘문서’라는 도구로, 개발자는 ‘코드’라는 도구로 서비스를 만들어내는 사람들이다.

    도구만 다를뿐, 서비스를 구현한다는 역할은 모두 동일하다.

    기획자의 기획서는 문서만 보고도 서비스를 만들수있을 정도로 디테일하고,

    또 모든 케이스에 대해서 플랜A, 플랜B가 모두 고려되있어야 한다.

    특히 아직 명확하지 않은 기능들에 대해서도, 명확시하여 기획을 하는것이 실력이다.

    (명학한 기능 명세는 누구나 할수있지 않을까?)

    또한 개발자는 기획자의 기획서를 바탕으로, 실제 해당 기획이 구현가능한 것인가, 현실에 부합하는 것인가를 판단하고, 피드백을 줄수있어야 한다. 무작정 따르는 개발자는 ‘코드몽키’밖에 되지 못한다.

    기획서의 명세를 정확히 판단하여, 피드백을 통해 더 현실적이고,

    나은 서비스를 만들수있게 의견을 적극적으로 주는 역할이 중요한 역할중에 하나이다.

    기획자와 개발자가 위와 같이 각자의 역할에 최선을 다하고,

    해당 부분에서 실력을 발휘할때,

    비로소 그 개발집단은 우수한 집단이라고 말할수있지 않을까? 생각해 본다.

  • [개발생각] Webview앱 vs Native앱

    앱을 만들때, 웹뷰로 만들지, 네이티브로 만들지는 한번쯤 고민해 보는것 같다. 참고로, 개인프로젝트면 웹뷰가 편하긴 한것같다..ㅋ

    (Dart, Swift등 또 배우기, 귀찮아…)

    웹뷰앱과 네이티브앱 장단점을 생각했을때,

    만약 최고의 앱을 만들 목표라면, 너의 선택은? 이라고 누군가 묻는다면,

    나는 ‘네이티브앱’을 선택할듯하다.

    외국어도 네이티브가 제일 외국어 잘하지… 앱도 네이티브가 성능, 기능면에서 더 뛰어난건 반론을 할수가 없지 않을까? ㅋ

    그렇다면, 네이티브앱이 가장 큰 단점이라고 생각하는것은? 이라고 묻는다면, 배포/장애대응등이지 않을까..

    하지만, 이걸 단점이라고 생각하기보다는, 장점을 얻기위한 트레이드오프라고 보고,

    배포/장애에 대한 대응을 잘 할수있도록,

    프로세스를 만들고, 실수를 줄이도록 배포과정을 정비하는데 더 신경을 쓴다면,

    단점이라고 보기도 어렵지않을까 한다..

    한 예로 ‘카xx 뱅크’ 초기에 앱을 어떻게 만들지를 정말 많이 논의했던것 같다.

    그때는 클라이언트 개발자, 서버 개발자, 기획자 모두 모여서, 브레인스토밍을 하며,

    어떻게 앱을 만들지를 이야기를 정말 많이 나눴다.(이 논의만 한달했나??)

    참, 희귀한 의견도 많이 나왔다 ㅋ 브레인스토밍이니 괜찮지!!

    그때 나온 의견들 몇가지.

    1) 유니티로 만들자.
    
      -  비주얼,이펙트를 끝내주게 만들자, 크로스플랫폼도 지원되니 일석이조다!


    2) 네이티브로 만들자 (안드로이드 : 코틀린, 아이폰 : 스위프트)
    
      - 네이티브앱이 정석이고, 가장 성능상으로도 뛰어나다. 가장 중요한것 'UX의 반응성'이 가장 빠르다.


    3) 웹뷰로 만들자 
    
      - 배포/장애대응이 빠르다 (웹서버 배포만 하면 해결된다.)


    4) 언리얼.... (이건..굳이 언급을..ㅋ)

    여기서 사실 네이티브앱과 웹뷰 의견이 가장 유력했다. 

    결론은 2번 네이티브로 만들기로 했다.

    이유는 간단하다.

    사용자의 UX가 모든 이유의 최우선이 되야한다는 기준이 있었기 때문이다.

    사용자에게 좋은 경험을 준다면, 그 이외의 다른 힘든 부분은 넘어야하고 해결해야하는 과제일 뿐이라는 생각에 결국은 모두가 동의했다.

    (때마침, 케이뱅크가 웹뷰앱으로 오픈했는데…참..별로긴했다)

    네이티브앱을 만들면, 클라이언트 개발자는 좀더 부담감을 갖게 되는게 사실 맞다.

    한번 배포가 되고, 개발이 잘못되면, 배포를 다시해야하고, 그 배포는 앱심사라는 단계를 거쳐야하기때문이다.

    (앱 심사 참 까다롭지…)

    그리고 앱심사시간만큼 배포/적용되는 시간도 더 걸리긴한다. 

    하지만, 우리는 먼저 이런 버그가 생기지 않게, 줄일수있는 방법을 먼저 생각을 해야하는것이 아닐까 한다.

    적어도 소프트엔지니어의 마인드를 가지고 있다면 말이다.

    우리는 잘못된 개발/버그를 줄이는 방법에 개발 초점을 맞춰야하고, 그것을 없애거나, 줄이기 위한 방법을 생각하는데 더 집중해야한다.

    골을 넣기위해 최선을 다해야 하지, 골을 먹고서 어떻게 할지를 먼저 생각을 하지않는것과 같다.

    하지만, 네이티브앱을 테스트하기란 상당히 어렵긴하다.

    디바이스 모델별, OS버전별, 종류별 수십종을 QA가 테스트를 진행한다.

    이렇게 테스트를 진행하기에, 버그를 줄일수있었던 것이다.

    이런 여력이 정말 없다면, 그때는 웹뷰앱도 고려를 해야하지 않을까? 생각이 든다.

    웹뷰앱도 성능을 올리기 위한 여러 테크닉이 있다.

    만약 웹뷰앱으로 만들기로 정했다면, 이런 테크닉들을 정말 잘 활용하여 잘 만들어야 하겠다.

  • [개발생각] CI/CD unittest를 위한 인프라 환경 구성의 방법

    Embadded infrastructure환경을 구축하자. (어디서든 테스트코드가 동작하게 만들자, 생각만해도 편하네)

    로컬에서 유닛테스트 코드를 작성하고, 로컬 도커에 설치된 인프라환경(mysql, kafka, redis등등)으로 붙어서,

    유닛테스트를 돌리게 구성을 해놨었다.

    참, 로컬에서 인프라환경을 도커로 구성하니, 유닛테스트하기도 좋기 참 편했다. (나름 만족!! ^^)

    그러던중, 이제 마지막 단계, CI/CD로 배포가 되는 파이프라인에도 unittest를 동작하도록 하고,

    모든 테스트가 성공할때, 빌드를 진행하려고 하니, 고민스러운 부분이 생겼다.

    바로 unittest infra환경이다.

    ci/cd가 독립적으로 인프라 환경을 구성하고, 해당 인프라 환경으로 접근하여, 유닛테스트가 실행되도록 하고싶었다.

    (마치 로컬에서 로컬도커로 인프라 접속하듯이…)

    확인해 보니,

    다행스럽게, kotest에는 extension과 test시점에 대한 event listener를 활용할수있었다.

    유닛테스트가 처음 구동되는 이벤트 (ProjectListener)를 구독하여,

    해당 시점 (beforeProject)에 extension이 동작하게 구성하고,

    extension기능 클래스에는 testContainer를 이용하여, 자체적으로 인프라 환경 도커를 띄우게하고,

    테스트코드가 동작하도록 구성을 하였다.

    object EmbeddedInfraExtensionCore  {
        lateinit var redisContainer: RedisContainer
            private set
    
        lateinit var s3Container: MinIOContainer
            private set
    
        lateinit var kafkaContainer: KafkaContainer
            private set
    
        const val REDIS_IMAGE = "redis:7.0.11"
        const val MINIO_IMAGE = "minio/minio:latest"
        const val KAFKA_IMAGE = "apache/kafka:3.7.0"
    
        val log = LoggerFactory.getLogger(EmbeddedInfraExtensionCore::class.java)!!


        fun beforeProject() {
            val unittestProperties = UnittestPropertiesLoader().load()
    
            redisContainer = RedisContainer(DockerImageName.parse(REDIS_IMAGE))
                .withExtraHost("localhost", "127.0.0.1")
                .withExposedPorts(6379)
                .waitingFor(
                    Wait.forListeningPort()
                )
            redisContainer.portBindings = listOf("${unittestProperties.redisPort}:6379")
            redisContainer.start()
            log.info("*Redis started at ${redisContainer.host}:${redisContainer.firstMappedPort}")
    
            s3Container = MinIOContainer(DockerImageName.parse(MINIO_IMAGE))
                .withUserName(unittestProperties.minioUserName)
                .withPassword(unittestProperties.minioPassword)
                .waitingFor(
                    Wait.forHttp("/minio/health/ready")
                        .forStatusCode(200)
                )
            s3Container.portBindings = listOf("${unittestProperties.minioPort}:9000", "${unittestProperties.minioConsolePort}:9001")
            s3Container.start()
            log.info("*Minio started at ${s3Container.host}:${s3Container.firstMappedPort}")
    
            kafkaContainer = KafkaContainer(DockerImageName.parse(KAFKA_IMAGE))
                .withStartupTimeout(Duration.ofMinutes(3))
            kafkaContainer.portBindings = listOf("${unittestProperties.kafkaPort}:9092")
            kafkaContainer.start()
            log.info("*Kafka started at ${kafkaContainer.host}:${kafkaContainer.firstMappedPort}")
        }
    
        fun afterProject() {
            redisContainer.stop()
            log.info("*Redis stopped")
    
            s3Container.stop()
            log.info("*Minio stopped")
    
            kafkaContainer.stop()
            log.info("*Kafka stopped")
        }
    }

    여기서 중요한것이 UnittestPropertiesLoader 클래스의 역할이다.

    beforeProject시점은 아직 스프링빈이 활성화가 되지않은 시점이기에,

    application-unintest.yml 등 설정 파일을 @Value나 Property등으로 wired해서 읽을수없다.

    직접 읽어야 한다 !!! (ㅠㅠ 아쉬워)

    해당 인프라의 포트, 어드민 정보등을 하드코딩해도 되지만, 설정관리와 일원화를 위하여,

    resource아래의 application-unintest.yml를 읽어서 해당 설정값을 추출하고, 이 값을 이용하여,

    Embedded 인프라 실행 환경을 구성하도록 하고 싶었다.

    그 의도에 의해서,

    UnittestPropertiesLoader를 하나 만들고, 직접 yml을 읽어서, 사용할 설정값을 뽑아내는 클래스를 작성하여 활용하였다.

    이렇게 unittest를 위한, Embedded 인프라 환경을 구성을 하였다.

    ci/cd에서 유닛테스트가 동작할때, 최초, 위 Extension이 구동되게 되고, TestContainer를 통해, 도커이미지가 로컬에 구성이 된다.

    (redis, kafka, db등등)

    그리고, unittest코드는 Embedded 인프라로 접속하여, 테스트코드가 동작하게 된다.

    테스트 코드 또한 프로덕션 코드와 같이, 잘 관리하고 효율적인 코드를 유지해야한다고 생각한다.

    위와 같이 구성을 함에 따라, 훨씬 테스트 코드를 사용함에 있어서 불필요한 걱정을 할 필요가 없어졌다.

    자동화 만세!!

  • [개발생각] 어플리케이션 레이어에서 UseCase와 Service의 동일시

    DDD, 클린아키텍쳐기반으로 설계를 하다보면, UseCase와 Service를 동일시 보고, 하나 개념으로 합치고 싶은 욕망이 들때가 있다.

    책이나, 블로그등에 따르면 뭔가 잘못된 생각같고, 찜찜하고 아닌것같은 생각을 하고, 잠시 욕망을 접었던 기억이 많다.

    대부분 책에서는 어플리케이션 레이어에서의 UseCase를 ‘행위의 정의’로 보고, Service는 이런 UseCase들을 이용한 ‘퍼사드 개념’으로 본다.

    그런데, 이론은 그렇다고 해도, 일반적인 서비스에서 저렇게 UseCase와 퍼사드 Service로 나뉘는 경우가 많을까? 의구심이 든다.

    그리고 Service를 UseCase의 정의대로 구현하면 (UserGetService, UserLoginService등),

    행위의 정의와 퍼사드 개념을 펄쳐서 구현을 하는건 크게 문제가 없어보이긴한다.

    다만 여기서 중요한건, UserGetService, UserLoginService은 원래의 UserService개념보다 좀더 큰 퍼사드 개념이 되야 하겠다.

    UseCase가 엄청나게 많이 존재하고, 그것들을 이용하는 퍼사드 Service클래스가 존재해야하는 정도의 서비스를 경험하기란 힘들기 때문이다. 하물며 요즘은 MSA아키텍처를 많이 사용하기에 그런 개념 또한 더 작게 쪼개지는 트랜드여서, 더더욱 그렇다.

    엄청나게 복잡하고 큰 서비스가 아니라면,

    그냥 맘편히, 어느정도는 UseCase와 Service를 같은 개념으로 보고,

    동일시하여 구현을 하는것도 시스템의 복잡도를 줄일수있는 하나의 선택이라고 생각이 든다.

    공자 슨생님은 40살을 ‘불혹’이라 하였다.

    ‘갈팡질팡하지않고, 내뜻대로 중심을 잡아 판단해도 틀리지 않을 나이’라고 했다.

    그냥 밀고 나간다…(40살 넘었으니…ㅠ)

    근데..틀리면 어쩌지…ㅋ

  • [개발생각] Test코드 작성시, Fixture의 관리에 대해서

    Mock용 객체를 기준값에서 파생되게 만들면, Mock객체의 통일성을 유지할수있고,  서로다른 테스트코드에서도 일관성을 유지하며 테스트코드를 작성할수있다.

    테스크 코드를 작성할때, Mock용 User정보, Address정보, Device정보등, 테스트 실행시 필요한 정적인, 준비된 데이트들을

    Fixture라는 명아래, UserFixture, AddressFixture,DeviceFixture 등의 이름으로 모아두고, 활용하게 된다.

    여기서 조금만 관리를 소홀히 하면, Fixture클래스는 온갖 데이터가 난무하는고, 중복 코드가 난무하는 클래스, 즉, 애물단지가 되버린다.

    여기서 Fixture를 더럽히는 가장 큰 요인하나가, 일관성없는 Mock용 데이터들 정의다.

    val user1 = User(id=1, name = '가나다41')
    
    val user2 = User(id=9999 name = '안녕333')


    val address1 = Address(id='addr1',  userId=1, name = '주소명1')
    
    val address2 = Address(id='address_33333',  userId=20, name = '서울시_xxxxx')


    val device1 = Device(id='v-1',  userId=1, name = 'device1')
    
    val device2 = Device(id='v:::0',  userId=22, name = '기계33')

    이런식으로 개발자 각자가 Fixture에 무심코 정의해서 사용하게되는데, 이런식의 Mock용 데이트들은 결국 중복코드를 만들고,

    Fixture안을 더럽히는 주범이 된다.

    또한, Mock데이트들을 개발,작성자가 임의로 만들게 됨에 따라, 규칙없이 만들게 되어, 같은 userId가 1이라도 name이 가나다41, 안녕333등 전혀 일관성 없는 이름들로 테스트 패키지안에 중복 존재하게 되고, 테스크코드 작성시 이런 중복된 userId를 발견하면,

    어떤것을 써야할지 고민 또한 만들게 된다. (같은 user1이 여러개 있는데, 어떤걸 써야할까?!!! 고민)

    참, 쓸데없는 고민이다… (개발에서 고민거리는 과감하게 없애는 방향으로 코딩을 해야한다고 생각한다. Simple is Best)

    그래서 이런 Mock데이터들은 해당 비즈니스 서비스에서 가장 기본이 되는 데이터를 중심으로 파생되는 방법으로 작성하게 만들어야 한다.이 방법이 가장 안전하고, 데이터의 일관성을 갖게하여, 관리의 포인트를 줄일수있다.

    가령, UserId를 기준으로 잡는다면,

    위의 Address객체는

    Value Class UserId(id:Long) 정의했다면,


    UserId.toAddress() = Address(id= "addr$id", userId = id,  name = "address$id")
    
    UserId.toDevice() = Device(id= "v$value", userId = id,  name = "device$id")

    이렇게, UserId기준으로 Address, Device등 파생되는 Mock데이터를 만들게 확장함수를 만들고,

    Fixture에 Mock객체를 정의하지말고, Test코드안에서 바로 사용하게 하여, 불필요한 Fixture의 객체 정의를 줄여야 한다.

    이런 방법을 사용하면, 한결 간결한 테스트 코드를 작성할수있고,

    데이터간의 정합성, 통일성또한 가져갈수있어서, 여러명의 개발자간의 Mock데이터사용이 통일되는 장점이 있다.

    사용예1)
    
    Test("테스트 코드") {
    
        val user = getUser(1);
    
        val mockAddress = user.id.toAddress()
    
        val mockDevice = user.id.toDevice()
    
    }


    사용예2)
    
    Test("테스트 코드") {
    
        val userId = UserId(1);
    
        val mockAddress = userId.toAddress()
    
        val mockDevice = userId.toDevice()
    
    }

    참, 간결해지고, 명시적이다!!!!

    테스트 코드를 등한시 하다, 테스트 코드가 복잡해지는 경험을 하게되었고, 고민을 통해, 위와 같은 방법으로 Fixture의 복잡성을 줄이는 방법을 생각해봤다. 테스트 코드도 코딩의 일부이기에, 테스트 코드를 잘 관리하고, 중복코드없게 만드는것 또한 꼭 필요한 작업이다.

  • [개발생각] 익숙치않은 개발(론)에 팀원들을 적응시키는 방법에 대해서

    개발자라면, 같은 회사에서 오랜기간 개발하게 되면, 그 회사만의 방식/방법에 익숙해지게 마련이고,

    마치 관습과도 같이 코드를 작성하게 된다.

    이런게 ‘콘웨이 법칙’의 예가 아닐까? ㅎㅎ

    만약 위와 같은 상황에 지속적으로 노출된다면, 개발자는 점점 관습으로 개발을 하게 되고,

    (관습이 나쁘다는 이야기는 아니다. 다만, 필연적으로, 개발에 고민하는 시간이 줄어든다는 이야기이다)

    어느 순간 개발자가 아닌 코더로 전락하게 된다.

    그런데 정말 무서운것은 코더가 된것을 자신은 모른다는것이다... 정말 무섭다..

    나도 코더였던 경험이 있다. (지금은 당연히 코더가 아니라고 자신있게 말할수있다 ㅎ)

    대학 졸업후에, 작은 SI개발회사에서 몇년 일하게 됬는데,

    어느 순간, 내가 일명 CCCV (컨트롤 C + 컨트롤 V)의 고수가 된걸 알게 되었다.

    그날 곰곰히 누워서 생각한게 있다.

    내가 몇년 개발한 코드들은 뭐지?? 내가 사용해왔던 기술에 대해서 설명을 할수있나??? 

    하나도 대답할수없다고 생각했다. 그냥 코더 CCCV가 되버렸었다.

    물론 그때의 충격이 지금은 보약이 되어, 그래도 지금은 노력하는 개발자가 되려고 하니… 다행이지..

    다시 본론으로 돌아와서,

    만약 위와 같은 기존 조직의 관습에 개발멤버들이 적응이 되버린 상황이라면,

    그리고, 전혀 다른 개발론, 개발방식, 개발언어로 신규 프로젝트를 하게 된다면,

    그리고, 감사하게도(??),

    내가 프로젝트리더가 된다면,

    어떻게 팀원들을 적응시켜야 할까?

    큰 고민이 될수있다.

    이 상황이라면, 프로젝트 진행 얼마간의 시간동안은 개발멤버들은 주니어 개발자들이라고 봐야한다.

    (바로 개발을 원활하게 할수없다면 주니어 개발자와 같은 조건이기 때문이다. 다만, 절대적인 주니어라고 생각하라는 이야기가 아니다. 퍼포먼스만의 기준으로만 봤을때, 이 프로젝트에서는 주니어의 퍼포먼스라고 생각하라는 의미이다. 이부분은 명확히, 오해가 없어야 한다.)

    그렇다면, 답은 나와있다.

    이 상황이라면, 팀원들에게는,

    1) 많은 의견을 요구해도 안되고 (의견을 줄수도 없는 상황일것이다.)

    2) 큰 기대을 걸어서도 안된다. (적응하는것만해도 스트레스가 어마어마할것이다.)

    3) 조급해해서도 안된다. (러닝커브가 높기에 일정 기간은 기다려 줘야한다.)

    4) 내가 포기해서도 더더욱 안된다. (시간이 지나면 많은 부분이 해결될것이다.)

    5) 항상, 프로젝트리더는, 팀원들에게 설명해주고, 같이 고민해주고, 의견을 제시해주는걸 중요시해야한다. 

    이 시점에 가장 팀원들에게 도움이 필요한것은 명확한 방법/방향을 제시해주는것이다.

    명확한 규칙/방법/방향을 제시하고,

    그 부분에 대해서 공유를 통해 잘 이해할수있게 시간을 할애하는것이다.

    (설령 당장은 이해를 못하다고 하더라도,지속적으로 시간을 할애해야한다)

    그리고 그 규칙에 맞게, 개발을 진행하게 하고, 그 규칙에 맞지 않으면, 다시 규칙에 맞춰서 개발을 하도록 ‘요구/지시’ 해야한다.

    때로는, 팀원들은 너무 짜여진 규칙/규율로 개발을 하는것이 답답하거나,

    자유롭고 창의적인 개발에 악영향을 주는것 같다는 생각을 할수도있다.

    하지만, 팀리더는 이런 상황은 눈 딱감고, 견뎌야 한다.

    이렇게 생각하는 이유를 적어본다.

    1) 새로운 방법에 대해서 이해를 하는건 상당한 러닝커브가 존재한다. 가장 좋은건, 그 방법에 익숙해 지는것이고, 그 방법에 익숙해지기위해서는 그방법 그대로 적용/개발하려고 해야한다. (게임 튜터리얼 하는 것과 비슷하다고 해야하나?ㅎ)

    2) 처음에는 규칙/방법/방향에 맞게 개발하는 것만해도 버겁다. 아마 같은 코드를 몇번을 다시 짜고, 몇번을 이클래스,저클래스로 옮겨야하는거야? 또는 값하나 사용하는건데 왜 이렇게 고민하고 시간을 들이는걸까? 라는 불만이 있을수있다. (불만이 없다면, 감사하다 ㅎ)

    3) 하지만, 참고 버티고, 그 규칙에 맞게 개발하다보면, 어느순간부터, 하나하나의 퍼즐조각이 맞춰지기 시작한다.

    궁금했던 부분이 이해 될것이고. 왜 이렇게 개발했고, 구조/설계가 됬는지 팀원들도 이해를 하게 되는 시점이 올것이다.

    4) 이 시점부터 아주 흥미로워진다. 이 시점 전까지는 프로젝트 리더는 외롭다.

    동조/의견을 나눌사람이 없거나, 부족하기에 혼자 개발하는 느낌을 받을수도있다.

    하지만 이 시점이 되면, 이제는 팀원들 사이에서, 슬슬, 구조/설계/개발에 대해서 하나둘 의견이 나오기 시작할것이다.

    (하나씩 하나씩 구조가 보이기 시작하기에)

    5) 기존의 규칙/방법/방향에 대한 개선 의견이 나오고, 처음에 정했던 방향에 대해서 수정이 필요하다는 의견들이 나온다면, 의견수렴을 거쳐 수정을 진행한다. (여기서 가장중요한건 초기의 규칙/방법/방향성을 잘 정해야한다는것이다. 잘 정하지 못한 방향성은 나중에 이 의견수렴을 통한 수정이 불가하게 되기에, 프로젝트 리더의 역할이 아주 중요하다) – 초기에 리더는 마치, 정신병자와 같이 설계/구조에 예민해야한다. 잘못된 수정/결정 하나,하나가 나중에는 스노우볼로 프로젝트에 돌아오게된다.

    6) 위의 경험을 한 팀원들은, 다른 신규 프로젝트에서는 개개인의 실력이 크게 발휘될것이다.

    위 내용을 간단히 정리하면 ‘무조건 그냥해! 그러면 나중에는 이해될꺼야!’ 라는식의 내용이 상당히 거북할수도있지만,

    팀원들이 동의하고, 잘따라와준다면, 나의 경험으로는 이게 가장 효율적인 방법중에 하나라고 생각된다.

    천재 개발자가 아닌이상, 전혀 경험하지 못한 환경에 바로 적응하고 이해하는 개발자가 몇이나 될까?

    이 개발자들은 바뀐 개발환경 하나하나가 버거운 대상이기에, 그 대상에 대해서 온전하게 집중할수있게 시간을 주어야하고 도와주어야 한다….

    (주의!! 부작용으로, 악덕업주라고 욕먹을수있음 ㅋ)

  • [개발생각] SOLID원칙에서 I의 경험에 대해서

    여러 같은 행위를 하는 Service 빈을 만들어야 할때가 있다.

    이경우, 각각의 공통된 행위/과정을 인터페이스 스펙으로 설계하고,

    그 인터페이스 스펙을 구현하는 AService, BService, CService를 만든다.

    첫단계에서는 이런 스펙들이 하나의 인터페이스 클래스에 같이 존재하게 되는데,

    이 스펙들이 많아지고, 성격이 틀리게 되면, 적절하게 그룹핑을 하고, 나눠야 하는 시점이 오게된다.

    ASpec, BSpec, CSpec등으로 인터페이스 클래스로 나누고, 해당 스펙을 구현하는 구현체를 만든다.

    구현체는 한개의 클래스에서 모두 구현하는게 아닌, 각각의 스펙별로 별개의 역할을 하는 구현체로 별도로 만드는게 훨씬 깔끔해진다.

    (일정부분, 단일책임원칙과도 맞는 부분이다)

    이 스펙 클래스를 구현한 구현체들은 스펙을 통해, 인터페이스화하여, 공통으로 사용가능하게 된다.

    예)

    @Service
    
    class ServiceFactory(
    
         val ASpecs:List<ASpec>
    
    ) 


    @Service
    
    class ServiceFactory(
    
         val BSpecs:List<BSpec>
    
    )

    위와 같이 스프링에서는 인터페이스를 구현한 Service Bean들을 List 또는 Map으로 주입받아 사용할수있기때문에,

    공통으로 처리해야하는 것들(동일한 스펙으로 같이 처리해야하는 기능들)이나,

    팩토리 패턴을 사용할때 간편하게 사용가능하고, 해당 기능에 대해서만 주입된 빈을 사용하기에, 더 명시적으로 사용가능하다.

    *(List, Map에서 특정빈을 사용하기위해서는 support():boolean 함수를 구현하도록 하면,

    특정빈을 선택해서 사용가능하게도 할수있다(팩토리 패턴))

    특히, 코틀린에서는 인터페이스를 역할별로 나누면, 좋은게 delegate를 사용해서 훨씬더 코딩을 간결하게 만들수있다.

    @Service
    class ProductService(
        private val cacheSupport: CacheSupport
    ) : CacheSupport by cacheSupport {
    
        fun getProduct(): Product {
            return cacheSupport.cache("product") {
                Product("cola", 1000)
            }
        }
    }
    
    @Service
    class ProductService(
        private val cacheSupport: CacheSupport
    ) : CacheSupport by cacheSupport {
    
        fun getProduct(): Product {
            return cache("product") {
                Product("cola", 1000)
            }
        }
    }

    첫번째처럼, cacheSupport.cache(xxxxx)로 사용하는 부분을 delegate를 사용하면,

    두번째처럼, cache(xxxx)로 바로 함수만으로 표현이 가능하고, 사용가능하다.

    ProductService에 cacheSupport의 역할을 위임하였기에, cache함수만으로도 표현이 가능하기 때문이다.

    (좀더 간결하고 보기 편한 코드로 표현할수있다는 장점이 있다)

    인터페이스는 역할별로 잘게 더 나누어 설계하고, 그 인터페이스의 구현체도 별개로 구현을 하도록 하자.

    그리고 그 구현체를 사용할때, List, Map으로 주입받아 사용하면, 훨씬 간단히, 깔끔하게 사용가능하다는것을 기억하자!!

  • [개발생각] toString()과 toInt()의 비교 순서에 대해서

    작은 차이가 명품을 만든다.. 어느 광고 카피가 생각난다.

    Int형 userId변수가 있고, string형 userIdStr변수가 존재하는데,

    이 두개의 값 자체는 정수값으로 같고, 타입만 틀린상태라고 해보자.

    이 두 변수를 비교해서 처리하는 로직이 아래와 같이 코딩되었다고 가정하면,

    if (userId.toString() == userIdStr) {
    
       //비즈니스 로직
    
    } else {
    
      //비즈니스 로직
    
    }

    이 코드가 잘 짜여진 코드일까? 생각해보자..

    단연코, 나는 아니라고 생각한다.

    엄청 심플한 코드 같지만, 정말 세밀한 차이로 코드의 퀄리티가 달라질수있다.

    위의 코드는 아쉽지만, 잘못 짜여진 코드라고 생각한다.

    userIdStr은 String형 타입, 문자열이기에, userIdStr안의 값이 정수값인지, 문자가 포함되있는지를 판단할수없다.

    따라서  userIdStr이 정수값이 아닌경우, 즉 데이터가 잘못들어간경우 (예: 1234ABC), else를 타게 된다.

    로직상으로는 맞다고 생각이 되지만, userIdStr자체가 잘못된값이 들어간 경우를 필터 할수없는 반쪽짜리 불안전한 코드이다.

    이 코드를 아래와 같이 수정하면 어떨까?

    if (userId == userIdStr.toInt()) {
    
        //비즈니스 로직
    
    } else {
    
       //비즈니스 로직
    
    }

    useIdStr을 toInt()로 변환해서 비교하게 살짝만 바꾸면, userIdStr에 문자열이 포함되 있는경우,

    toInt() 변환시 넘버포메팅 예외가 발생하고, else를 타지않을것이다.

    변환하는 변수만 바꾸었을뿐인데, userIdStr에 잘못된 값이 들어간 오류를 걸러낼수있고, else문도 타지않게 할수있다.

    훨씬 논리적으로 탄탄한 코드가 된다.

    이 작은 차이가 코드를 명품을 만든다.

    코드가 더 추가된것도 아니고, 순서만 바꾼 코드이지만, 그 영향력은 엄청나다.

    AI가 아무리 발전했다고 하더라도, 이런 세세한 조정까지 할수있는 것은 아직은 인간 개발자뿐이라고 생각한다.

    (물론, 저런 세밀한 것까지 생각하고 개발 할수있는 개발자가 있다는 전제가 있긴하지만..ㅎ)

    항상 한줄 한줄 코딩할때, 왜! 라는 단어를 우리는 ‘꼭’ 명심해야한다….

    우연히 무심코, 첫번째 코드를 보고, 넘겼다가, 번개처럼 뒤통수를 맞으며, 두번째 코드각 생각나서… 글을 써본다.

    그래도 뿌듯하구나..(이 정도까지 왔구나..나란 녀석..ㅎㅎ)

  • [아이디어] AI끼리 싸움을 붙이면..

    가끔씩 생각한적이 있다, AI끼리 썰전을 펼치고, 그걸 지켜보면 얼마나 잼있을까??

    내말이 맞네, 네말이 맞네 하며 인간처럼 치고박고 하는 것을 지켜보는 관음증 환자가 되면 얼마나 짜릿한 느낌일까!!!

    AI모델은 각각 특색이 있다.

    어떤분야에 더 집중하여 학습을 시켰는지에 따라서, 모델별로 더 답변을 잘 주는 부분이 미세하게 존재한다.

    그렇기 때문에, AI모델 하나만 선택해서 사용하는것보다는 여러 AI모델들을 늘어놓고, 질문을 모든 AI모델에게 하는 방법이 더 좋은 정보를 얻을수있지 않을까? 생각한적이 있다.

    이런 방식에 가장 적합하다고 생각한 아이디어가, AI들끼리 구성된 개발팀을 만들면 어떨까? 라는 생각이다.

    그래서 바로 만들어 봤다.

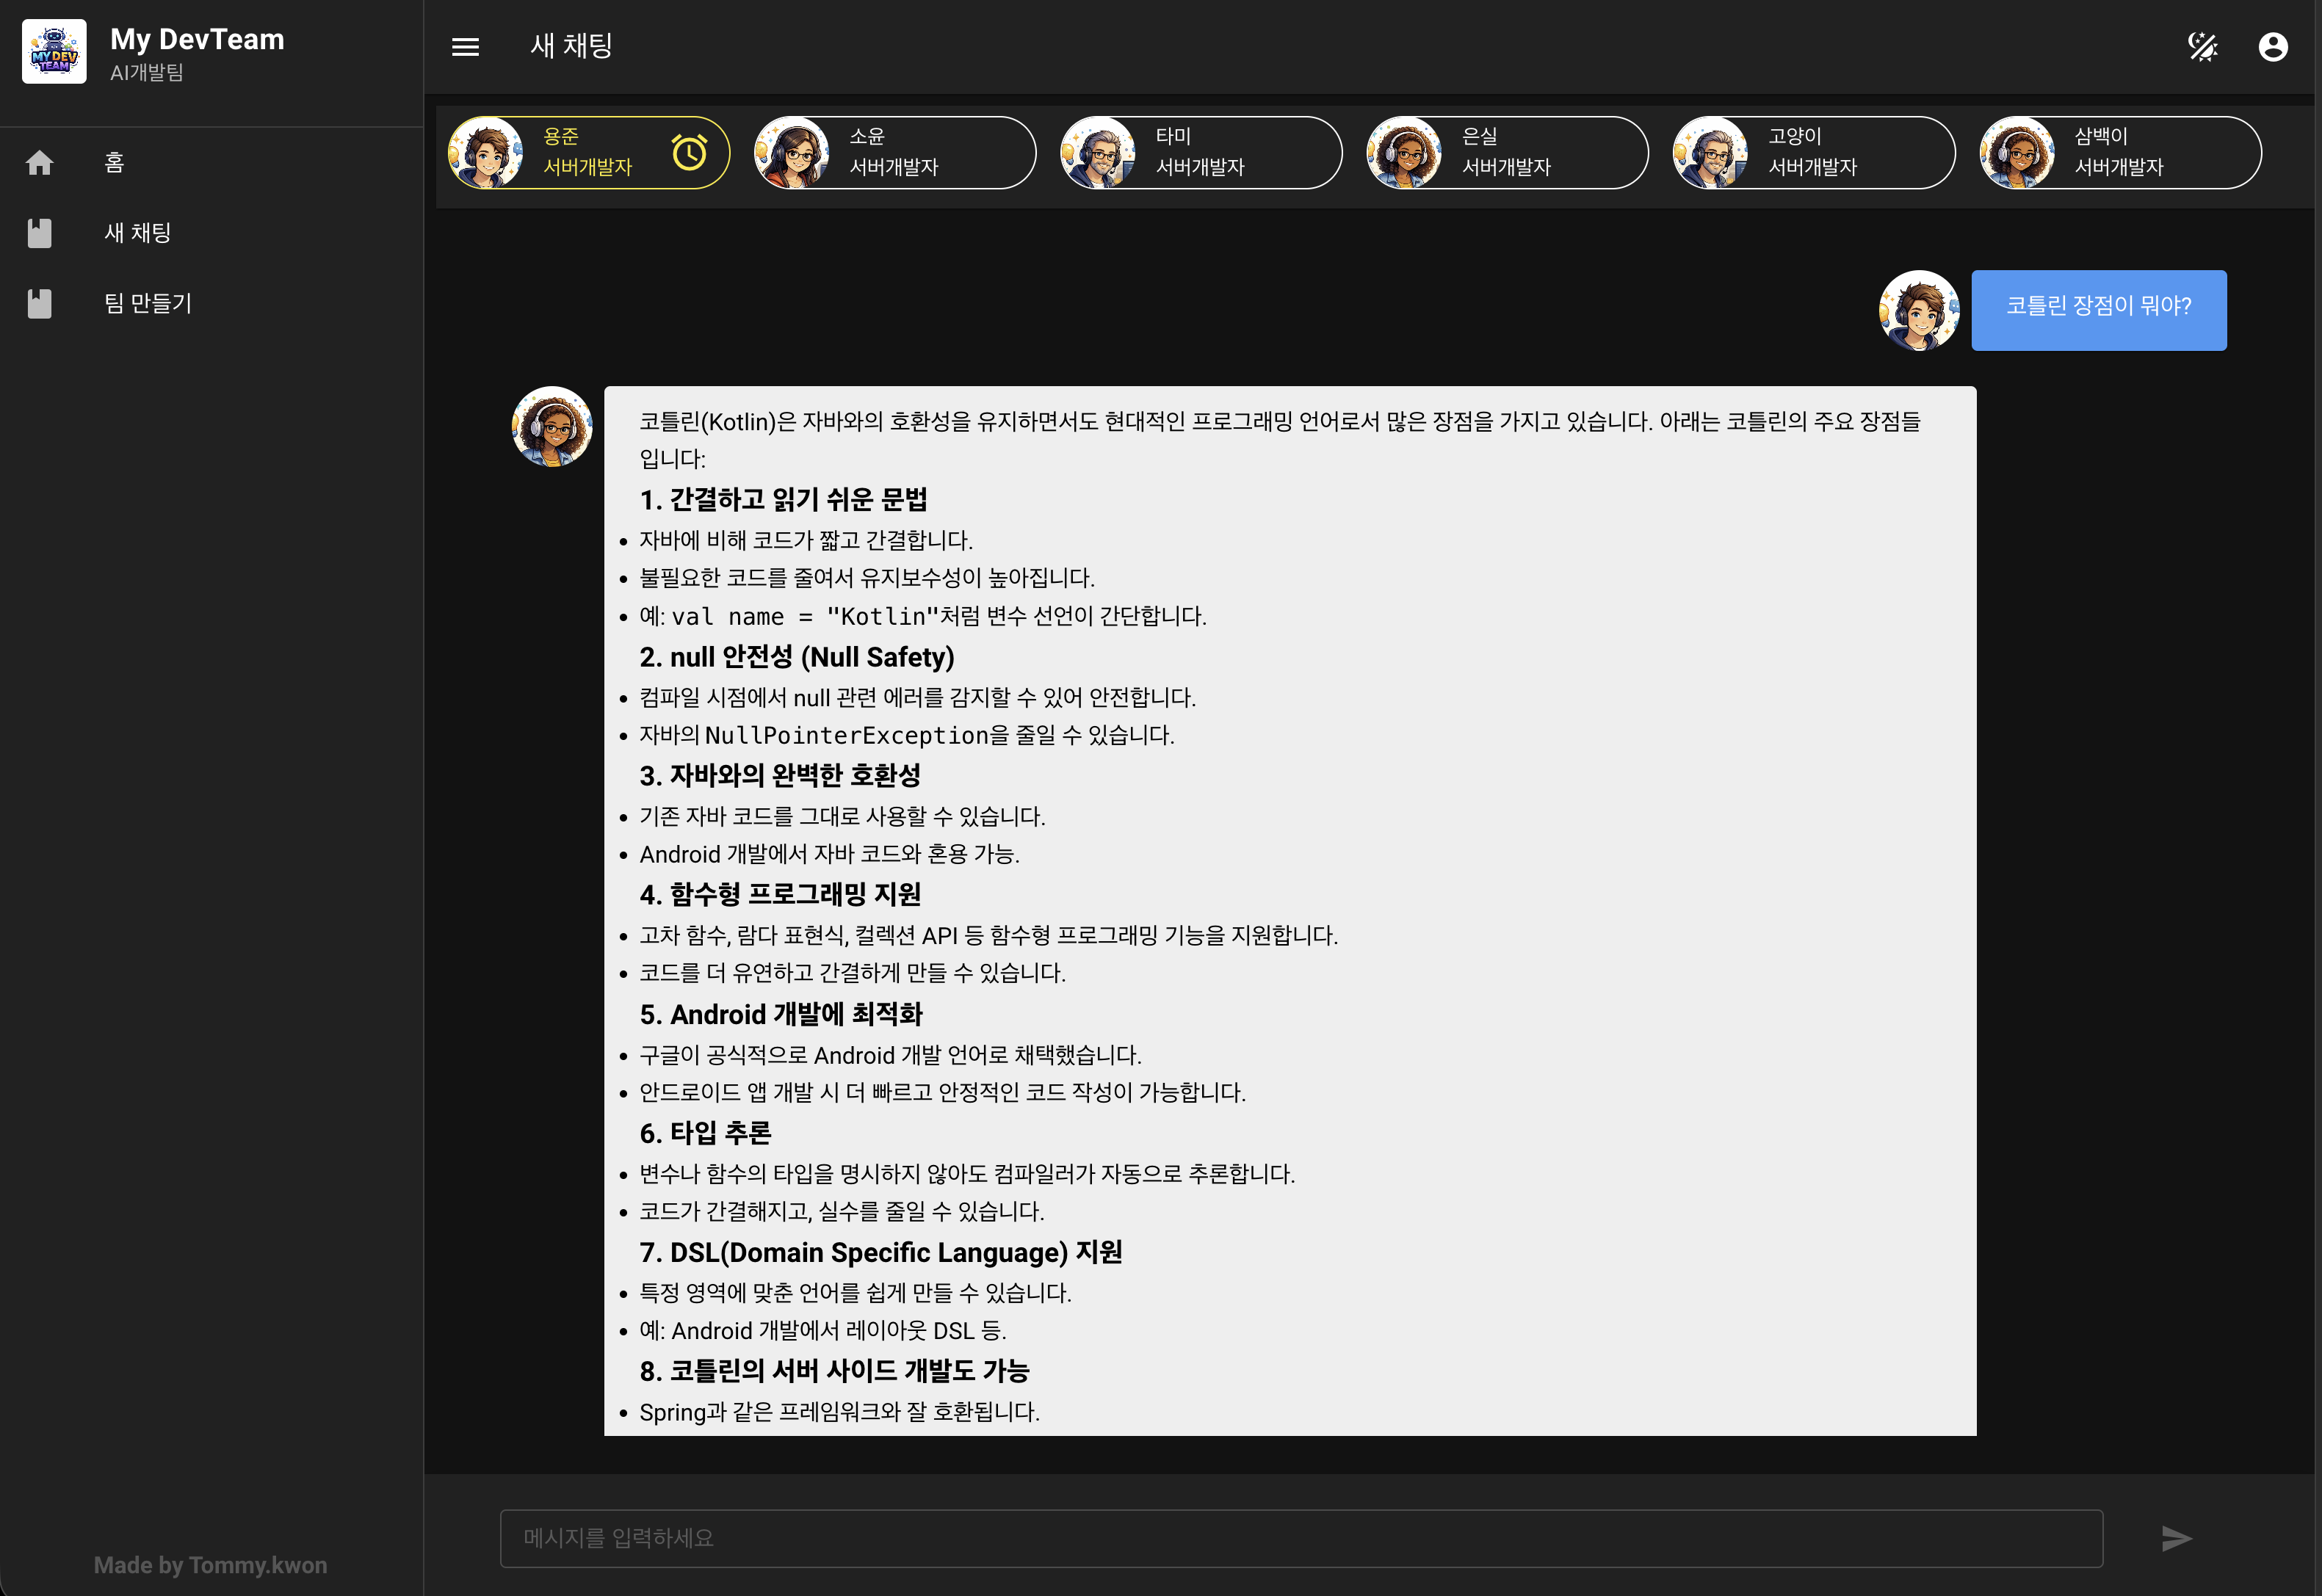
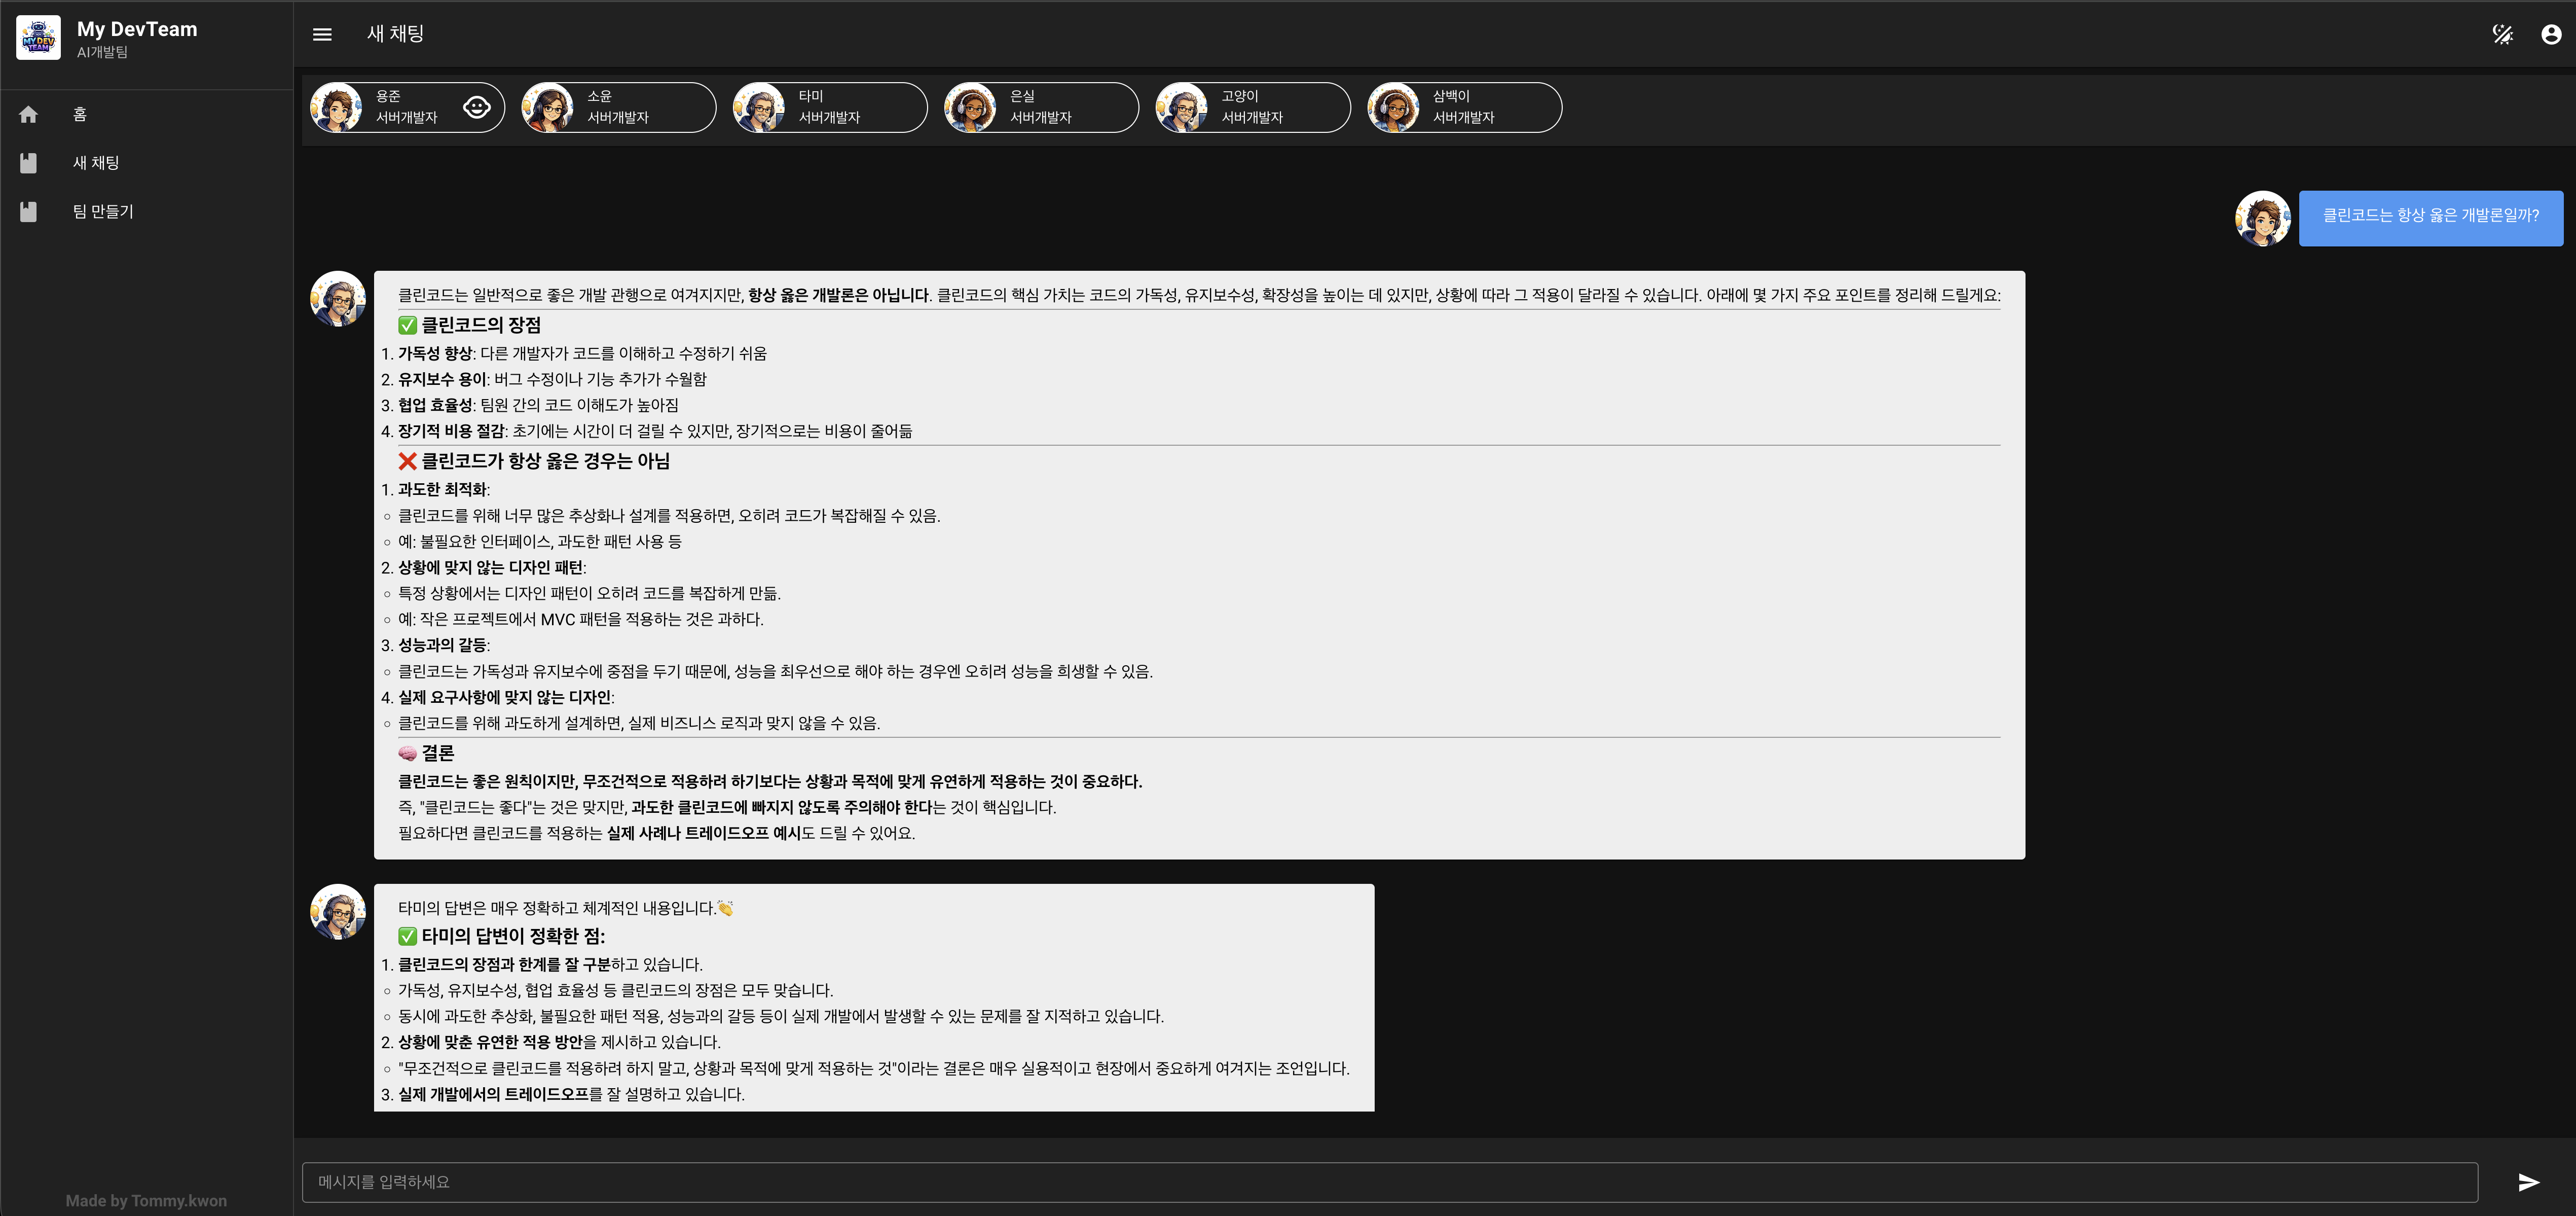
    서비스 이름은 ‘My Dev Team’ !!!

    AI모델별로

    ‘친절하고 꼼꼼한 시니어 백앤드 개발자’,

    ‘빠르고 냉철한 시니어 백앤드 개발자’,

    ‘아이디어가 넘치는 백앤드 개발자’,

    ‘창조적인 시니어 디자이너’,

    ‘유식하고 지식이 풍부한 시니어 프론트 개발자’라는 메타포를 적용하고 (프롬프트에 룰로 각각의 성격과 능력을 위와같이 정리해줬다),

    이 AI개발팀에게 개발에 대한 질문을 하고 각각의 분야에 대해서,

    서로 의견을 공유하고, 의견을 주고 받으며, 더 좋은 의견을 만들어 가고,

    나중에는, 의견들의 결론을 종합해서 대답해주는 서비스가 있으면 어떨까? 라는 아이디어가 떠올랐다.

    바로… 시도해봤다 ㅋ

    완벽하게 만들려면 시간이 오래걸릴것 같지만, 생각한 아이디어로 충분히 구현이 가능할것같다는 결론은 내렸다.

    우선 mcp를 위해 langchain보다는 spring ai를 사용하였다.

    ai쪽 개발은 거의 처음이라, langchain의 학습난이도가 좀 있어서, 빠르게 만들기위해서는 익숙한 spring 생태계의 spring-ai 모듈을 사용했다.

    (다음번에는 langchain으로 만들어 봐야지…)

    학습모델은 우선 공짜인 ollama를 사용하였다.

    많은 학습모델을 pull 받아서 바로 사용할수있기에 엄청 편했다.

    나중에는 chatgpt나 클로드등의 모델을 연동하면, 훨씬 퀄리티가 좋아질것같다. (비용이 많이 들겠지만..)

    MY Dev Team 서비스를 만들때,

    가장 큰 고민 부분이 하나 있었다.

    상당히 답이 안나오는 부분이긴했는데…뭐냐면,

    A ai가 답변을 했다고 하면, A ai의 답변에 대해서 B,C,D ai중에 누가 그 답변을 이어 받아서, 의견(답변)을 줘야 하느냐이다..

    A의 답변에 대해서 B,C,D 모두에게 답변을 요청할수도있지만, AI모델이 모두 답변을 하기위해서는 상당한 CPU, GPU 자원이 들고,

    시간또한 많이 든다.(거의 평균 30초?!)

    이부분을 아래와 같이 플로우 설계를 하였다.

    마치 쇼프로의 mc처럼 의견들을 중재하고, 진행을 할 Decision AI를 하나 더 만들었다.

    그리고 Decision AI 모델은 A,B,C,D의 대화를 항상 청취하고 있다. (대화의 컨텍스트를 유지함)

    Decision AI 모델은 코드 학습 모델이 아닌, 대화에 대한 객관적 판단/정보 파악을 주로 학습한 가벼운 모델로 선정했다.

    (이유는 빠른 응답을 위해 Decision AI는 지식이 중요하지 않고, 중간에서 MC와 같이, 누가 질문/답변을 더 잘할지만 판단해 주면 되기에,무거운 모델은 사치라고 생각했다)

    [플로우의 예는 아래와 같다.]

    1) A가 답변이 끝났다.
    
    2) Decision AI가 A의 답변에 대해서, 가장 잘 응답/의견을 줄수있는 AI를 선택한다. (예: B가 선택)
    
    3) Decision AI가 선택한 B에게 A의 답변에 대해서 의견을 묻는다.
    
    4) B가 답변을 한다.
    
    5) 2번으로 돌아가 Loop를 돌며 지속적으로 의견을 묻고 답한다.
    
    6) Decision AI는 Loop를 돌며 각각의 AI들에게 의견을 묻고 결론을 내려야 할 시점이라고 판단하면, 대화를 끝내고 summary하여 대화를 마무리한다.
    
    7) 사용자는 위 1-5번의 대화를 지켜본다. (FT에서 채팅이 계속 표현되며 진행된다)

    나중에 좀더 발전시키면,

    프롬프트의 명확할 룰 정리와 의견과 답변 그리고 반론등을 더 구분지어 Decision ai에게 컨텍스트 전달하게 하면,

    (아마 벡터 디비나, 그래프 디비를 도입을 해야할것같다 ㅠ)

    마치 사람들끼리의 대화와 같은 리얼한 대화가 될것으로 보인다.

    이 서비스는 시간을 투자하여, 천천히 발전해 봐야겠다.

    역시 백앤드 개발자라도, AI 대세에는 적응해야 하는가보다…ㅠ

  • [개발생각] 도메인VO를 컨트롤러의 입력파라미터로 써도될까?에 대한 고민

    개발자의 욕심은 끝이 없으니, 재사용, 재사용이라는 프레임에 갇히고, 또 의미를 잃어버리고…

    도메인VO를 정의할때, 대부분 그냥 Value Class (코틀린)로 정의해서 사용한다.

    즉, 대부분은 단순 Wrap 클래스로만 VO를 정의하고 사용한다.

    타입 안정성과 명시적 의미부여에 큰 의미를 둘 수 있기에, Wrap 클래스 정도만이여도 상당히 강력하다고 생각하기 때문이다.

    하지만, 좀더 서비스가 복잡해지고 방대해 진다면, (즉, 다뤄야하는 도메인이 많아진다면)

    VO가 다양해지고, 해당 VO의 값에 대한 벨리데이션 검증 로직을 VO로 빼는 경우도 많게 된다.

    예를 들면

    Value Class Email(value:String) {
    
         init {
    
              //value 검증 로직. (Email포멧 검증, 비즈니스 로직 검증등등) 문제있으면 예외 발생
    
         }
    
    }

    이렇게 도메인VO에 값에 대한 검증로직을 넣게 되면, 해당 VO 생성시, 값에 대한 검증이 되고, 재사용도 가능하니, 편하다.

    그리고, 욕심도 하나 생긴다…

    해당 VO를 application 레이어의 컨트롤러의 입력파라미터로 사용하면, 검증도 동일하게 할수있으니, 일석이조아닐까?? 라고…

    물론, DDD의 의미에 따르면,

    Application 레이어에서의 Email의 검증은 단순 값 (NotBlank),형식등의 검증만 구현되어야 하고,

    도메인VO에서의 Email의 검증은 비즈니스 로직상에서 필요한 데이터의 값의 검증으로 이원화 되어,

    관리되어야 이상적이라는건 이미 인지하고 있다.

    어플리케이션 레이어와 도메인 영역에서의 비즈니스 로직은 명확히 연관이 없게 해야하며, 별개로 관리해야한다가 전제조건이기 때문이다.

    하지만, 그건 말그대로 이상적인 이야기인것같다고 문득 생각이 들었다.

    Email값 검증의 룰이 값의 검증과 비즈니스 로직의 검증으로 나눠지는 경우가 실무에서 얼마나 있을까??

    다른 입력값들 또한 그렇게 명확히 구분되고 나눌수 있는 경우가 얼마나 될까? 생각해보면, 그 케이스는 거의 없을것 같다는 생각이 든다.

    그럼, 여기서 의문점이 생긴다….

    어플리케이션레이어에서 도메인VO를 스리슬쩍, 사용해도 될까?!

    더 정확히는 도메인 VO에 구현된 값 검증 벨리데이션 로직을 어플리케이션에서도 사용해도될까? 라는 의문이다..

    이렇게 되면 장점은,

    어플리케이션 레이어에서 잘못된 값이 입력될때, 실제 서비스 레이어까지 도달하지않고, 바로 예외를 발생시키기에 불필요한 연산/리소스 낭비가 없게 된다.

    도메인 서비스 영역까지 오기전에 이미 값검증에서 예외가 발생하기때문이다.

    이 부분은, 성능/리소스/속도/효율 등에 미친 개발자에게는 또 엄청난 매력으로 다가오는 부분이기도 하다. (내가..그 미친개발자중에 하나..)

    뭔가 합리적이고, 현실타협점에서 선택된 쿨한 방법 같아보이기도 한다.

    그런데…

    고민끝에 어플리케이션 레이어에서 도메인VO의 검증룰은 재사용하지 않기로 맘먹었다. (정말 생각 많이 한거같다)

    도메인 주도개발은 사실, 눈에 보이는 옅은 효율성을 넘어서,

    서비스들의 영역을 명확히 분리하고,

    설령, 비슷한 개념의 코드가 각각의 영역에 중복 존재한다고 하여도, 그 부분을 상쇄할수있는 독립성이 지켜진다면,

    기꺼이 그렇게 하겠다는 의지에서 시작한다고 생각한다.

    중복 개념의 객체가 존재한다고 하여도, 사실은 그 각각은 각자의 변경에 독립성을 부여받았기 때문에, 추후에는 서로가 달라질 확률과 기회가 있는 객체들이고 개념이다.

    즉, 엄청나게 확장에 열려있고 수정에 닫혀있게 된다는 뜻이다.

    도메인VO 또한 이런 개념으로 생각한다면, 검증로직을 같이 사용하는건 그 확장을 닫히게 하는 시발점이 될수도있다.

    하나 예를 들어보면,

    어플리케이션 레이어에서 컨트롤러의 입력파라미터중에 email:String이 존재하고, 도메인Vo에 EmailVo가 존재한다고 하면,

    email -> 검증은 NotBlank, 이메일 형식 검증등

    EmailVo -> 이메일 도메인에 대한 검증 (kakako.com이메일만 허용), email이 포워딩 이메일인지에 대한 검증, 이메일의 형식이 해당 서비스에서 만들어준 형식만 정상으로 보는 케이스등

    이런식으로 분리를 하는게 맞다.

    미래에는 (서비스를 유지보수하면서) 해당 도메인 영역에서 EmailVo가 하나만 존재한다고 장담 할수없기 때문이다.

    PrivateEmailVo, PublicEmailVo, CorpEmailVo등 비지니스 요구사항이 반영된 VO가 여러개 생길수있고,

    이 각각의 의미는 도메인의 비즈니스 로직과도 타이트하게 연관이 될수가 있다. 

    따라서, 해당 검증을 어플리케이션 레이어에 넣게 되면,

    도메인 비즈니스 로직이 어플리케이션 레이어와 타이트하게 엮일 확률이 커지며,

    Email이라는 단순 파라미터의 의미가, 앞단에서 비즈니스 개념으로 세분화 되고, 다양해지게 되버린다..

    당장, API 문서기술에서도 아마 혼란이 올것이다.

    따라서 어플리케이션 영역에서는 좀더 표준적인 의미로 값을 받고,

    도메인쪽으로 해당 값을 넘길때는 도메인VO를 통해, 비즈니스 의미가 담긴 데이터로 검증후 변환된 데이터를 사용하는 흐름을 취하는게, 맞는 방향이라고 생각했다.

    뭐, 하지만 개발이라는건 100% 답이 없는 행위중에 하나니, 내가 생각한게 100%맞다고는 할수없겠다..

    하지만,

    정답은 아니라도, 올바른 방향정도는 되지 않을까? 생각해본다. 🙂